जब रोबोट को प्रोग्राम करना डेटा की समस्या नहीं रहती
पिछले तीन वर्षों में रोबोटिक्स में आई अधिकांश पूंजी में एक अंतर्निहित दांव छुपा है: कि यदि पर्याप्त मानवीय प्रदर्शन (demonstrations) उपलब्ध हों, तो रोबोट वही सीख लेंगे जो मनुष्य करते हैं। यह तर्क लुभावना इसलिए है क्योंकि यह एक बार काम कर चुका है — भाषा मॉडलों के साथ। लेकिन रोबोटिक्स टेक्स्ट नहीं है, और यह अंतर उन लोगों को महंगा पड़ने लगा है जिन्होंने माना था कि वही नुस्खा वही परिणाम देगा।
UC Berkeley और NVIDIA ने 2026 की कॉन्फ्रेंस ऑन रोबोट लर्निंग में जो प्रस्तुत किया, वह इस प्रतिमान का क्रमिक सुधार नहीं है। यह उससे एक विदाई है। उनके द्वारा एजेंटिक रोबोटिक्स नाम दी गई इस प्रस्तावना का तर्क है कि समस्या डेटा की कमी नहीं थी, बल्कि गलत अड़चन पर हमला किया जा रहा था।
वह ठहराव जिसे कोई घोषित नहीं करना चाहता था
UC Berkeley में रोबोटिक्स के प्रोफेसर और Ambi Robotics के सह-संस्थापक Ken Goldberg वर्षों से Siemens और Bosch जैसे औद्योगिक निर्माताओं के साथ काम कर रहे हैं। उनका निदान सीधा है: इमिटेशन लर्निंग एक हद तक काम करती है, और वह हद निवेशकों की उम्मीद से कहीं जल्दी आ जाती है। उन्होंने कहा, "शुरुआत में डेटा से अच्छा प्रदर्शन मिलता है, लेकिन फिर चीजें गलत होने लगती हैं। और डेटा बढ़ाया जाता है। लेकिन तब दूसरी चीजें गलत होने लगती हैं।" इस बात का कोई स्पष्ट संकेत नहीं है कि सिस्टम अभिसरण (convergence) की ओर बढ़ रहा है।
मूल समस्या संरचनात्मक है। भाषा मॉडलों को मानवता द्वारा उत्पादित समस्त पाठ के एक महत्वपूर्ण अनुपात पर प्रशिक्षित किया गया था। रोबोटिक्स का कोई भी डेटासेट उस पैमाने के करीब नहीं पहुंचता, और इसे भौतिक रूप से बनाना — वास्तविक परिवेशों में रिकॉर्ड किए गए मानवीय प्रदर्शनों के ज़रिये — एक धीमी और महंगी प्रक्रिया है। जिन कंपनियों ने इस आधार पर पूंजी जुटाई कि डेटा सब कुछ हल कर देगा, वे आज एक असहज प्रश्न के सामने खड़ी हैं: और कितना चाहिए, और क्या वह "पर्याप्त" बाज़ार का धैर्य चुकने से पहले कभी आएगा भी।
जो बात निदान को और जटिल बनाती है वह यह है कि इमिटेशन लर्निंग ऐसे सिस्टम तैयार करती है जिनका आसानी से ऑडिट नहीं किया जा सकता। ये उच्च औसत प्रदर्शन वाले ब्लैक बॉक्स हैं जो सबसे अनुचित क्षणों में अप्रत्याशित तरीके से विफल हो सकते हैं। औद्योगिक अनुप्रयोगों में, जहां "विफलता" का अर्थ उत्पादन लाइन का रुकना या किसी की चोट हो सकता है, उस जोखिम प्रोफाइल को किसी संचालन समिति के सामने उचित ठहराना कठिन है।
डेटा की जगह कोड: Berkeley और NVIDIA का प्रस्तावित मोड़
एजेंटिक रोबोटिक्स डेटा की कमी की समस्या को कोड जनरेशन की समस्या में बदल देती है। और इसके लिए भाषा मॉडलों के पास पर्याप्त पैमाना है।
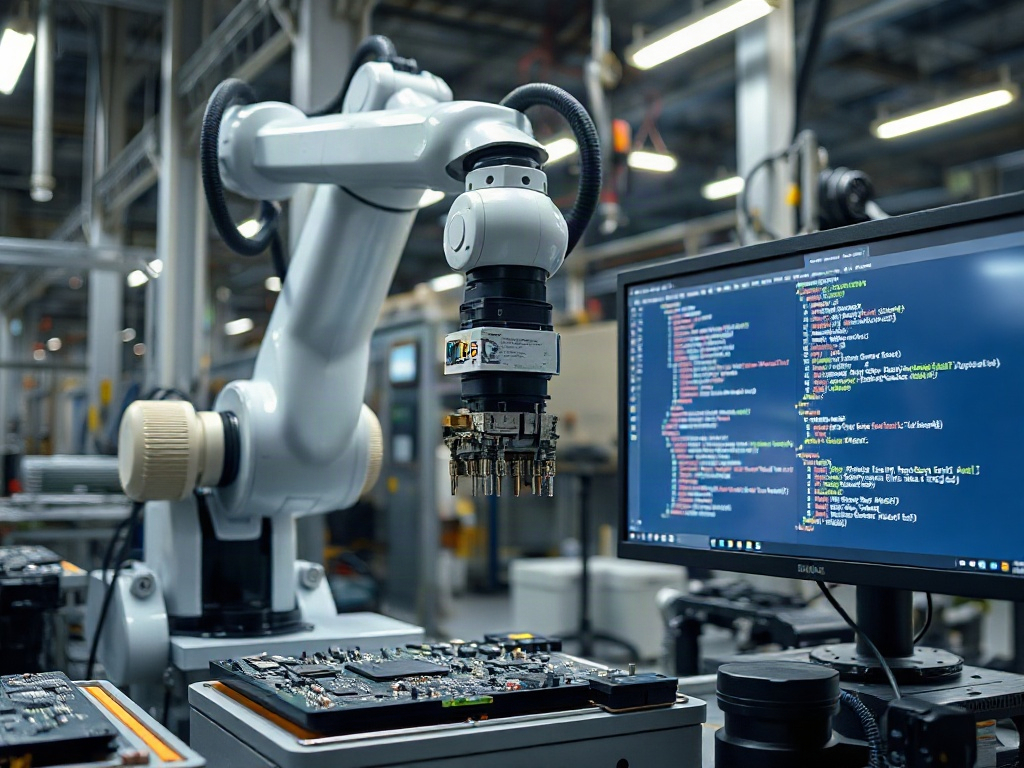
प्रक्रिया इस प्रकार काम करती है: प्राकृतिक भाषा में एक लक्ष्य — जैसे उत्पादों को बैग में पैक करना या सीरिंज को अपशिष्ट कंटेनर में डालना — को उप-कार्यों में विभाजित किया जाता है। विशेष कोड एजेंट, यानी स्वायत्त AI सिस्टम जो सॉफ्टवेयर लिख, परख और संशोधित करने में सक्षम हैं, विशिष्ट कार्यों की जिम्मेदारी लेते हैं: दृश्य बोध (visual perception), पोज़ अनुमान (pose estimation), गति नियोजन (motion planning), ग्रिपर नियंत्रण। प्रत्येक एजेंट पहले से मौजूद रोबोटिक्स लाइब्रेरीज़ का उपयोग करता है, जो ऑब्जेक्ट वर्गीकरण, ट्रैजेक्टरी नियोजन और गति नियंत्रण में दशकों के विकास का प्रतिनिधित्व करती हैं। परिणामी कोड सिमुलेशन में चलाया जाता है, एजेंट विफलताओं की पहचान करते हैं, मापदंड समायोजित करते हैं और पुनः पुनरावृत्ति करते हैं।
Berkeley के परीक्षणों में प्रलेखित परिणाम मूल्यांकन किए गए कार्यों में 99% तक की सफलता दर तक पहुंचे, जबकि उन्हीं कार्यों में इमिटेशन लर्निंग विधियों के लिए यह लगभग 20% था। यह अंतर मामूली नहीं है।
एक ऐसा पहलू जो विशेष ध्यान देने योग्य है वह है सिमुलेशन स्वयं। किसी सिमुलेटेड परिवेश को इतनी सटीकता से कॉन्फ़िगर करना कि जनरेट किया गया कोड भौतिक दुनिया में उपयोगी हो, ऐतिहासिक रूप से एक गहन मैनुअल कार्य रहा है। Goldberg और उनकी टीम ने जो दिखाया वह यह है कि एक एजेंट सिमुलेटर के मापदंडों — प्रकाश, ज्यामिति, पृष्ठभूमि — को वास्तविक परिवेश के वीडियो से मेल खाने के लिए स्वयं समायोजित कर सकता है। Goldberg का वर्णन बड़ा मार्मिक था: "हमें रोंगटे खड़े हो गए। दोनों को साथ-साथ देखने पर, सिमुलेशन और वीडियो में अंतर करना बहुत मुश्किल था।" यह भौतिक स्थानांतरण (transfer) की समस्या हल नहीं करता, लेकिन इंजीनियरिंग कार्य की एक परत समाप्त कर देता है जिसके लिए पहले विशेषज्ञों की आवश्यकता होती थी।
आर्किटेक्चर में गुणवत्ता नियंत्रण की एक परत भी शामिल है: एक प्रतिकूल (adversarial) एजेंट जिसे दूसरे एजेंट के उत्पादन में खामियां ढूंढने के लिए डिज़ाइन किया गया है। NVIDIA में रोबोटिक्स इंजीनियरिंग के निदेशक Spencer Huang ने इसे व्यावहारिक ढंग से वर्णित किया: "हम सभी जानते हैं कि AI एजेंट बकवास उत्पन्न कर सकते हैं। इसका मुकाबला करने के लिए, हम प्रतिकूल सेटअप का उपयोग करते हैं।" यह संशय को प्रक्रिया में, बाहरी सुधार के रूप में नहीं, बल्कि विकास चक्र के हिस्से के रूप में शामिल करने का एक तरीका है।
विनिर्माण में क्या काम करता है और बाहर अभी भी क्या नहीं
शोध से उभरने वाला सबसे ठोस मामला Wistron से जुड़ा है, जो NVIDIA के GPUs के लिए मदरबोर्ड बनाने वाली ताइवानी कंपनी है। जब यह कंपनी अपनी लाइन में कोई नया उत्पाद जोड़ती है, तो एक अकेले रोबोट को पुनः कॉन्फ़िगर करने में कम से कम आठ घंटे लगते हैं। एजेंटिक रोबोटिक्स के साथ, Huang का कहना है कि यह समय एक या दो मिनट तक गिर जाता है। यदि यह आंकड़ा वास्तविक उत्पादन में टिकता है, तो प्रभाव परिचालन नहीं बल्कि वित्तीय होगा: छोटी उत्पादन लाइनें, उपकरणों का बेहतर उपयोग, और उत्पाद परिवर्तनों के प्रति प्रतिक्रिया की क्षमता जिसके लिए आज हफ्तों पहले नियोजन की आवश्यकता होती है।
Huang का उद्धृत दूसरा उदाहरण सेमीकंडक्टर उद्योग है, जहां कुछ असेंबली प्रक्रियाओं में 0.3 मिलीमीटर की सटीकता के साथ घटकों को रखना आवश्यक है। यह एक ऐसी सीमा है जिसे पारंपरिक औद्योगिक रोबोट, यदि ठीक से प्रोग्राम किए जाएं, पूरा कर सकते हैं। लेकिन यह वह सीमा नहीं है जिसे मौजूदा मानवाकार (humanoid) रोबोट प्लेटफार्म उस उद्योग की मांग के अनुरूप दोहराव (repeatability) के साथ हासिल कर सकते हैं। इस उपयोग मामले के लिए, एजेंटिक रोबोटिक्स कुछ ऐसा प्रदान करती है जो सामान्य-उद्देश्य ह्यूमनॉइड पर दांव अभी तक नहीं दे पाए: अत्यधिक सटीकता की स्थितियों में सिद्ध विश्वसनीयता।
यहीं पर Alphabet की रोबोटिक्स कंपनी Intrinsic के मुख्य वैज्ञानिक Torsten Kroeger अधिक तकनीकी कठोरता के साथ ब्रेक लगाते हैं। उनका तर्क यह नहीं है कि दृष्टिकोण गलत है, बल्कि यह है कि भौतिक संपर्क की समस्या किसी भी मौजूदा भौतिकी इंजन द्वारा हल नहीं की गई है। सिमुलेशन वास्तविकता जैसा दिख सकता है; इससे यह गारंटी नहीं मिलती कि यांत्रिक व्यवहार — घर्षण, विकृति, टकराव — को उस विश्वस्तता के साथ मॉडल किया गया है जो वास्तविक औद्योगिक परिस्थितियों में किसी रोबोट को वस्तुओं में हेरफेर करने के लिए चाहिए। उस अंतर को मॉडलों की एजेंसी नहीं भरती, उसे सिमुलेटर की भौतिकी भरती है। और उस मोर्चे पर, पूरा क्षेत्र अभी भी पीछे है।
Kroeger एक ऐसी बात भी उठाते हैं जिसके नियामक परिणाम होंगे, इससे पहले कि क्षेत्र इसे वैचारिक रूप से हल कर सके: यदि एजेंट स्वायत्त रूप से रोबोट कोड उत्पन्न और संशोधित करते हैं, तो यह कैसे स्थापित किया जाए कि वह कोड हमेशा सुरक्षित है। तर्क यह नहीं है कि एजेंट विफल होते हैं, बल्कि यह है कि जैसे-जैसे स्वायत्त संशोधनों का पैमाना बढ़ता है, मानवीय समीक्षा क्रमशः कम व्यवहार्य होती जाती है। यह संरेखण (alignment) की समस्या है जो भौतिक विनिर्माण में स्थानांतरित हो गई है, और इसके परिणाम शुद्ध सॉफ्टवेयर की तुलना में कहीं अधिक ठोस हैं।
सबसे दिलचस्प तर्क प्रदर्शन नहीं है: यह मूल्य का आर्किटेक्चर है
बेंचमार्क परिणाम संवाद करने का सबसे आसान हिस्सा हैं और शायद यह तय करने के लिए सबसे कम प्रासंगिक हिस्सा है कि इस दिशा का उत्पादन में भविष्य है या नहीं। जो बात अधिक मायने रखती है वह वह थीसिस है जिसे Huang ने अपनी प्रस्तुति के अंत में प्रस्तुत किया और जो ध्यानपूर्वक जांच की मांग करती है।
उनका तर्क यह है कि रोबोटिक्स में सामान्य बुद्धिमत्ता (general intelligence) पहले एक ऐसे एजेंट के रूप में आएगी जो पारंपरिक तकनीकों और विशेष नीतियों का समन्वय करता है, न कि एक एकल मॉडल के रूप में जो सब कुछ शुरू से सीखता है। बाहरी पर्यवेक्षक के लिए, परिणाम सामान्य बुद्धिमत्ता जैसा लगता है क्योंकि एजेंट सब कुछ सुसंगत रूप से समन्वित करता है। नीचे, अच्छी तरह परिभाषित घटक होते हैं जो वही करते हैं जो वे जानते हैं।
इसके उद्योग में मूल्य के वितरण के लिए निहितार्थ हैं। NVIDIA केवल रोबोट प्रशिक्षण के लिए कंप्यूट बेचने पर दांव नहीं लगा रहा। वह इस पर दांव लगा रहा है कि रोबोट विकास, सिमुलेशन, कोड जनरेशन, सत्यापन और रीटास्किंग की पूरी प्रक्रिया उसके सॉफ्टवेयर इंफ्रास्ट्रक्चर से गुज़रे। Isaac Lab-Arena, Newton भौतिकी इंजन, रोबोटिक्स लाइब्रेरीज़: यदि रोबोट के लिए कोड जनरेट करने वाले एजेंट इन उपकरणों का डिफ़ॉल्ट रूप से उपयोग करते हैं क्योंकि ये उपलब्ध और अच्छी तरह से दस्तावेज़ीकृत हैं, तो NVIDIA उद्योग की मानक विकास परत बन जाती है, न केवल चिप आपूर्तिकर्ता।
इसके अलावा एक फीडबैक तर्क है जिसका Huang ने स्पष्ट रूप से उल्लेख किया: रोबोट के लिए एजेंटों द्वारा जनरेट किया गया कोड अगले मॉडलों के लिए प्रशिक्षण डेटा बन सकता है। यदि यह सच साबित होता है, तो एजेंटिक रोबोटिक्स केवल आज की डेटा कमी की समस्या को हल नहीं करती। यह उन्हें बड़े पैमाने पर, उच्च गुणवत्ता के साथ और स्पष्ट सिमेंटिक संरचना के साथ उत्पन्न करने का एक तंत्र बनाती है — जो मानवीय प्रदर्शन डेटा में शायद ही कभी होता है।
वास्तविक जोखिम यह नहीं है कि दृष्टिकोण सिमुलेशन में काम नहीं करता। इसके काम करने के प्रमाण पहले से मौजूद हैं। जोखिम वह है जो हमेशा उन दांवों के साथ होता है जो तकनीकी रूप से सही हैं लेकिन भौतिक दुनिया में स्थानांतरण में समय से पहले हैं: कि प्रयोगशाला और उत्पादन लाइन के बीच की दूरी बाज़ार के सत्यापन से पहले लाभ के मार्जिन को खा जाए। जो निर्माता इसका मूल्यांकन कर रहे हैं, वे सिमुलेशन में 99% सफलता दर वाला एक शोध पत्र नहीं खरीद रहे। वे अपने संयंत्र में, अपने रोबोटों के साथ, अपनी सामग्रियों और सहनशीलताओं के साथ सिद्ध विश्वसनीयता खरीद रहे हैं। वह सत्यापन अभी भी लंबित है, और वही तय करेगा कि यह दिशा मानक बनती है या किसी ऐसी चीज़ की राह पर एक और पड़ाव मात्र, जो अभी भी परिभाषित होना बाकी है।