ロボットのプログラミングがデータの問題でなくなるとき
過去3年間でロボット工学に流入した資本の大部分には、暗黙の賭けが存在する。それは、人間によるデモンストレーションを十分に積み重ねれば、ロボットは人間のすることを学習できるというものだ。この論理は魅力的に映る。なぜなら、言語モデルの分野でかつて機能したからだ。しかしロボット工学はテキストではなく、その違いが今、同じレシピで同じ結果が得られると思い込んでいた人々に高くつき始めている。
UCバークレーとNVIDIAが2026年のロボット学習に関する学会(Conference on Robot Learning)で発表した内容は、このパラダイムの漸進的な改善ではない。それはパラダイムからの決別だ。両者がエージェンティック・ロボティクス(agentic robotics)と呼ぶ提案は、問題の根源はデータ不足ではなく、間違ったボトルネックを攻略しようとしていた点にあると主張する。
誰も発表したくなかった停滞
UCバークレーのロボット工学教授でAmbi Roboticsの共同創業者であるKen Goldbergは、SiemensやBoschをはじめとする産業製造業者と長年協力してきた。彼の診断は率直だ。模倣学習はある時点までは機能するが、その時点は投資家が期待していたよりも早く訪れる。「最初はデータで良い性能が出る。しかし、やがてうまくいかなくなる。データを追加する。しかし、今度は別のことがうまくいかなくなる」と彼は述べた。システムが収束しているという明確なシグナルは存在しない。
根本的な問題は構造的なものだ。言語モデルは、人類がこれまでに生み出したテキスト全体のうち、相当な割合を学習データとしている。ロボット工学の分野には、その規模に近づくデータセットは存在せず、実際の環境で記録した人間のデモンストレーションによってそれを物理的に構築することは、時間とコストのかかるプロセスだ。データがすべてを解決するという前提のもとで資金を調達した企業は今、不快な問いに直面している。あとどれだけ必要なのか、そして「十分な量」が市場の忍耐が尽きる前に達成できるのかという問いだ。
診断をさらに複雑にするのは、模倣学習が誰にも容易に監査できないシステムを生み出すという点だ。これらは平均的な性能は高いがブラックボックスであり、最も不都合なタイミングで予測不可能な形で故障する可能性がある。産業用途においては、「故障」が生産ラインの停止や負傷を意味し得る場合、そのリスクプロファイルを運用委員会の前で正当化することは難しい。
データの代わりにコード:バークレーとNVIDIAが提案する転換
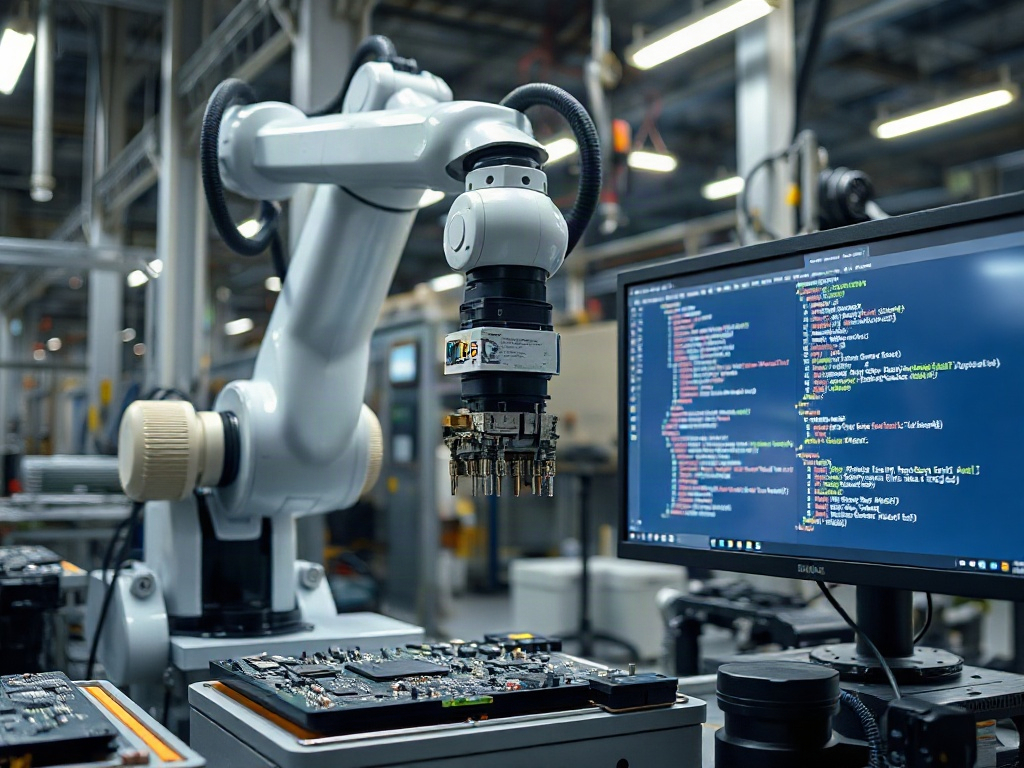
エージェンティック・ロボティクスは、データ不足の問題をコード生成の問題へと転換する。そして、そのためには言語モデルが十分なスケールを持っている。
フローはこのように機能する。製品を袋に詰める、注射器を廃棄物容器に入れるといった自然言語によるタスク目標が、サブタスクへと分解される。コードに特化したエージェント、すなわちソフトウェアを自律的に記述・テスト・修正できるAIシステムが、特定の機能を担当する。その機能とは、視覚的認識、姿勢推定、動作計画、グリッパー制御などだ。各エージェントは、物体分類、軌道計画、動作制御における数十年にわたる開発の成果である既存のロボット工学ライブラリを使用する。生成されたコードはシミュレーション環境で実行され、エージェントは失敗を特定し、パラメータを調整し、反復を繰り返す。
バークレーのテストで記録された結果は、評価されたタスクにおいて最大99%の成功率に達し、同一タスクにおける模倣学習の手法のおよそ20%と比較された。この差は些細なものではない。
特に注目に値する側面は、シミュレーション自体だ。生成されたコードが物理世界で有用となるに足る精度でシミュレーション環境を設定することは、これまで労働集約的な手作業であった。GoldbergとそのチームがしたのはあるAIエージェントがシミュレータのパラメータ(照明、ジオメトリ、背景など)を調整し、実際の環境のビデオに合わせることができると示したことだ。Goldbergの表現は印象的だった。「鳥肌が立ちました。並べて比較すると、シミュレーションと実際の映像を見分けるのは非常に困難でした。」これは物理的な転移の問題を解決するものではないが、以前は専門家を必要としていたエンジニアリング作業の一層を取り除く。
このアーキテクチャには品質管理の層も含まれている。それは別のエージェントが生み出したものの欠陥を見つけるよう設計された敵対的エージェントだ。NVIDIAのロボティクス担当エンジニアリングディレクターであるSpencer Huangは、現実的な言葉でこう説明した。「AIエージェントがゴミを生成することは、誰もが知っています。それに対抗するために、私たちは敵対的なセットアップを使います。」これは懐疑主義を外部からの修正としてではなく、開発サイクルの一部として組み込む方法だ。
製造業で価値があることと、外ではまだ機能しないこと
研究から浮かび上がってくる最も具体的な事例は、NVIDIAのGPU用マザーボードのメーカーである台湾のWistronに関するものだ。同社が生産ラインに新製品を組み込む際、ロボット1台の再設定には最低でも8時間かかる。エージェンティック・ロボティクスを用いれば、Huangによるとその時間は1〜2分に短縮されるという。このデータが実際の生産環境で維持されるならば、影響は操業上のものにとどまらず財務的なものになる。生産サイクルの短縮、設備稼働率の向上、今日では数週間前からの計画が必要な製品変更への対応能力の向上だ。
Huangが挙げるもう一つの例は半導体産業だ。一部の組み立てプロセスでは、0.3ミリメートルの精度でコンポーネントを配置する必要がある。これは適切にプログラムされた従来型の産業用ロボットが達成できる閾値だ。しかし、現在の汎用ヒューマノイドロボットプラットフォームが、この産業の要求する再現性を持って達成できる閾値ではない。このユースケースに対して、エージェンティック・ロボティクスは汎用ヒューマノイドへの賭けがまだ提供できていないものを提供する。それは極めて高い精度条件下での実証済みの信頼性だ。
ここで、AlphabetのロボティクスカンパニーIntrinsicの最高科学責任者であるTorsten Kroegerが、より厳密な技術的見地からブレーキをかける。彼の主張はアプローチが間違っているというものではなく、物理的接触の問題はいかなる既存の物理エンジンによっても解決されていないというものだ。シミュレーションは現実と同一に見える場合がある。しかし、それはロボットが実際の産業条件下で物体を操作するために必要な忠実度で、摩擦、変形、衝撃といった機械的挙動がモデル化されることを保証しない。そのギャップはモデルのエージェンシーでは埋まらず、シミュレータの物理エンジンが埋めるものだ。そしてその点において、分野全体が依然として遅れを取っている。
Kroegerはまた、業界がそれを概念的に解決する前に規制上の影響が生じることになるだろうと指摘している。エージェントがロボットのコードを自律的に生成・修正する場合、そのコードが常に安全であることをいかにして確立するかという問題だ。エージェントが失敗するということではなく、自律的な修正のスケールが拡大するにつれて、人間によるレビューが実行可能でなくなっていくという問題だ。これは整合性の問題を物理的な製造環境に移し替えたものであり、純粋なソフトウェアにおけるよりもはるかに具体的な結果をもたらす。
最も重要な議論は性能ではなく、価値のアーキテクチャだ
ベンチマーク結果は最も伝達しやすい部分だが、この方向性が本番環境で将来性を持つかを判断する上でおそらく最も関連性の低い部分でもある。より重要なのは、Huangがプレゼンテーションの終盤に定式化した命題であり、注意深く検討に値する。
彼の主張は、ロボット工学における汎用知能は、ゼロから何もかも学習する単一モデルとしてではなく、従来技術と特化型ポリシーを調整するエージェントとして最初に現れるだろうというものだ。外部から見ると、エージェントがすべてを首尾一貫して調整するため、汎用知能のように見える。その背後では、明確に定義されたコンポーネントがそれぞれの得意なことをしている。
これは、業界における価値の分配に関して示唆を持つ。NVIDIAが賭けているのは、ロボット訓練のためのコンピューティング販売だけではない。ロボットの開発、シミュレーション、コード生成、検証、タスク変更のプロセスが自社のソフトウェアインフラを通過するということに賭けている。Isaac Lab-Arena、物理エンジンNewton、ロボット工学ライブラリ——ロボット用コードを生成するエージェントが、利用可能でドキュメントが充実しているという理由からこれらのツールをデフォルトとして使用するなら、NVIDIAはチップのサプライヤーにとどまらず、業界の標準的な開発レイヤーとなる。
さらに、Huangが明示的に言及したフィードバックの議論もある。ロボット用にエージェントが生成したコードは、次のモデルの訓練データになり得るというものだ。それが実現するならば、エージェンティック・ロボティクスは今日のデータ不足の問題を解決するだけでなく、高品質で明確な意味的構造を持ち、人間のデモンストレーションデータがほとんど持たないスケールでデータを生成するメカニズムを創出することになる。
真のリスクは、このアプローチがシミュレーションで機能しないということではない。機能するという証拠はすでに存在する。リスクは、技術的には正しいが物理世界への移転において時期尚早な賭けに常に伴うものだ。すなわち、実験室と生産ラインの間の距離が、市場がその優位性を検証する前に利益マージンを食いつぶすというリスクだ。これを評価している製造業者は、シミュレーションで99%の成功率を示す論文を購入しているのではない。自社の工場で、自社のロボット、素材、許容差において実証された信頼性を購入している。その検証はまだ行われておらず、それこそがこの方向性が業界標準となるか、あるいはまだ定義されていない何かへの道における更なる一つの反復にとどまるかを決定するものだ。