Quando programmare i robot smette di essere un problema di dati
C'è una scommessa implicita nella maggior parte del capitale che è affluito nella robotica negli ultimi tre anni: che con un numero sufficiente di dimostrazioni umane, i robot impareranno a fare ciò che fanno gli esseri umani. La logica è seducente perché ha già funzionato una volta, con i modelli linguistici. Ma la robotica non è testo, e questa differenza sta cominciando a costare cara a chi aveva dato per scontato che la stessa ricetta avrebbe prodotto lo stesso risultato.
Ciò che UC Berkeley e NVIDIA hanno presentato alla Conferenza sull'Apprendimento in Robotica del 2026 non è un miglioramento incrementale su quel paradigma. È una rottura con esso. La proposta che hanno denominato robotica agentica sostiene che il problema non era la mancanza di dati, ma che si stava attaccando il collo di bottiglia sbagliato.
Il plateau che nessuno voleva annunciare
Ken Goldberg, professore di robotica a UC Berkeley e cofondatore di Ambi Robotics, lavora da anni con produttori industriali, tra cui Siemens e Bosch. La sua diagnosi è diretta: l'apprendimento per imitazione funziona fino a un certo punto, e quel punto arriva prima di quanto gli investitori si aspettassero. "Si ottengono buone prestazioni con i dati all'inizio, ma poi le cose vanno storte. Si aggiungono altri dati. Ma allora altre cose vanno storte", ha descritto. Non c'è alcun segnale chiaro che il sistema stia convergendo.
Il problema di fondo è strutturale. I modelli linguistici sono stati addestrati con una frazione significativa di tutto il testo che l'umanità ha prodotto. Non esiste alcun dataset di robotica che si avvicini a quella scala, e costruirlo fisicamente, attraverso dimostrazioni umane registrate in ambienti reali, è un processo lento e costoso. Le aziende che hanno raccolto capitale sulla premessa che i dati avrebbero risolto tutto si trovano oggi di fronte a una domanda scomoda: quanto manca, e se quel "sufficiente" arriverà mai prima che la pazienza del mercato si esaurisca.
Ciò che complica ulteriormente la diagnosi è che l'apprendimento per imitazione produce sistemi che nessuno riesce ad auditare con facilità. Sono scatole nere con alte prestazioni medie che possono fallire in modi imprevedibili nel momento meno opportuno. Per le applicazioni industriali, dove "guasto" può significare una linea di produzione ferma o un infortunio, quel profilo di rischio è difficile da giustificare davanti a un comitato operativo.
Codice al posto dei dati: la svolta proposta da Berkeley e NVIDIA
La robotica agentica converte il problema della scarsità di dati in un problema di generazione di codice. E per questo, i modelli linguistici dispongono già di una scala sufficiente.
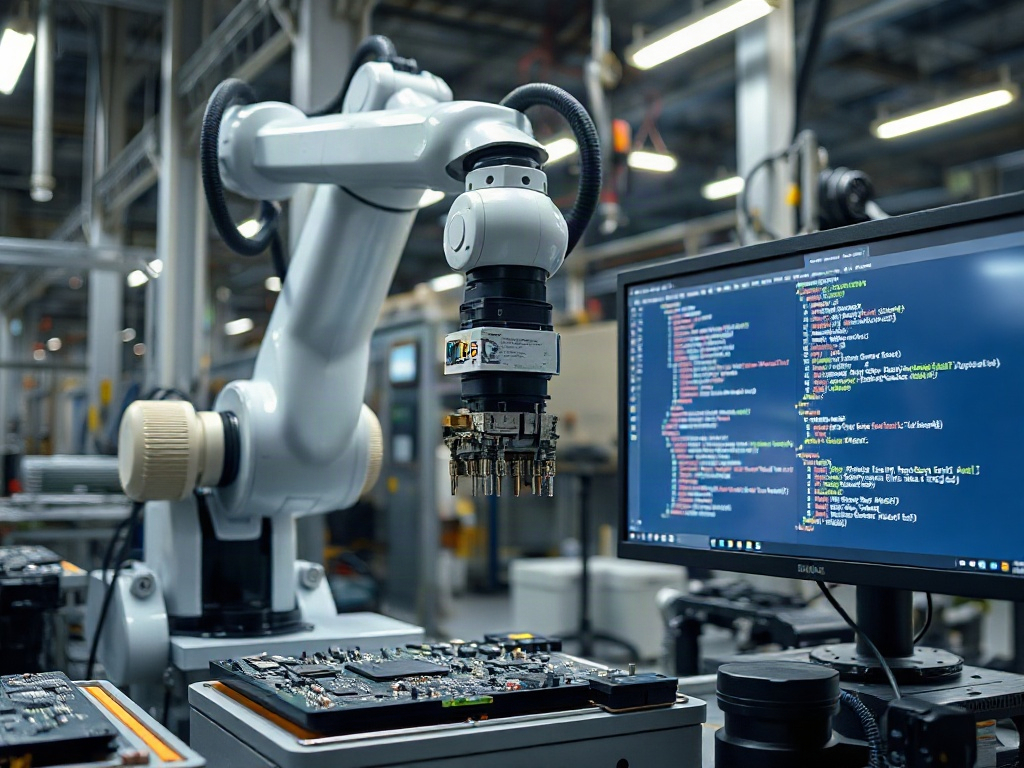
Il flusso funziona così: un obiettivo in linguaggio naturale, come confezionare prodotti in una busta o depositare siringhe in un contenitore per rifiuti, viene scomposto in sottocompiti. Agenti di codice specializzati — sistemi di intelligenza artificiale autonomi capaci di scrivere, testare e modificare software — si occupano di funzioni specifiche: percezione visiva, stima delle pose, pianificazione del movimento, controllo del gripper. Ogni agente utilizza le librerie di robotica già esistenti, che rappresentano decenni di sviluppo nella classificazione degli oggetti, nella pianificazione delle traiettorie e nel controllo del movimento. Il codice risultante viene eseguito in simulazione, gli agenti identificano i guasti, regolano i parametri e iterano nuovamente.
Il risultato documentato nei test di Berkeley ha raggiunto tassi di successo fino al 99% nelle attività valutate, rispetto a circa il 20% per i metodi di apprendimento per imitazione nelle stesse attività. Il divario non è marginale.
Una dimensione che merita attenzione è la simulazione stessa. Configurare un ambiente simulato con precisione sufficiente affinché il codice generato sia utile nel mondo fisico è stato storicamente un compito manuale intensivo. Ciò che Goldberg e il suo team hanno mostrato è che un agente può regolare i parametri del simulatore — illuminazione, geometria, sfondo — affinché corrispondano a un video dell'ambiente reale. La descrizione di Goldberg è stata eloquente: "Ci ha fatto venire i brividi. Confrontando fianco a fianco, era molto difficile distinguere la simulazione dal video." Questo non risolve il problema del trasferimento fisico, ma elimina uno strato di lavoro di ingegneria che prima richiedeva specialisti.
L'architettura include anche uno strato di controllo qualità: un agente avversariale progettato per trovare i difetti in ciò che un altro agente produce. Spencer Huang, direttore dell'ingegneria robotica di NVIDIA, lo ha descritto con pragmatismo: "Tutti sappiamo che gli agenti di intelligenza artificiale possono produrre spazzatura. Per contrastarlo, utilizziamo configurazioni avversariali." È un modo di incorporare lo scetticismo all'interno del processo, non come correzione esterna ma come parte del ciclo di sviluppo.
Ciò che vale nella manifattura e ciò che non funziona ancora fuori
Il caso più concreto che emerge dalla ricerca coinvolge Wistron, produttore taiwanese di schede madri per le GPU di NVIDIA. Quando quell'azienda incorpora un nuovo prodotto nella sua linea, riconfigurare un singolo robot richiede un minimo di otto ore. Con la robotica agentica, Huang afferma che quel tempo scende a uno o due minuti. Se quel dato regge in produzione reale, l'impatto non è operativo ma finanziario: linee di produzione più snelle, maggiore utilizzo delle apparecchiature, capacità di risposta ai cambiamenti di prodotto che oggi richiedono una pianificazione con settimane di anticipo.
L'altro esempio che Huang cita è l'industria dei semiconduttori, dove alcuni processi di assemblaggio richiedono il posizionamento di componenti con una precisione di 0,3 millimetri. È una soglia che i robot industriali convenzionali, ben programmati, possono rispettare. Non è una soglia che le piattaforme di robot umanoidi attuali possano raggiungere con la ripetibilità richiesta da quell'industria. Per quel caso d'uso, la robotica agentica offre qualcosa che le scommesse sui robot umanoidi a uso generale ancora non garantiscono: affidabilità verificabile in condizioni di estrema precisione.
È qui che Torsten Kroeger, direttore scientifico di Intrinsic, l'azienda di robotica di Alphabet, mette il freno con maggiore rigore tecnico. Il suo argomento non è che l'approccio sia sbagliato, ma che il problema del contatto fisico non è risolto da nessun motore fisico esistente. La simulazione può sembrare identica alla realtà; questo non garantisce che il comportamento meccanico — attrito, deformazione, impatto — venga modellato con la fedeltà necessaria a un robot per manipolare oggetti in reali condizioni industriali. Quel divario non lo colma l'agentività dei modelli, lo colma la fisica del simulatore. E su quel fronte, l'intero settore è ancora indietro.
Kroeger solleva anche qualcosa che avrà conseguenze normative prima che il settore lo abbia risolto concettualmente: se gli agenti generano e modificano il codice dei robot in modo autonomo, come si stabilisce che quel codice sia sempre sicuro. L'argomento non è che gli agenti falliscano, ma che man mano che la scala delle modifiche autonome cresce, la revisione umana diventa progressivamente meno praticabile. Questo è il problema dell'allineamento trasferito alla manifattura fisica, e ha conseguenze molto più concrete che nel software puro.
L'argomento più interessante non è la performance: è l'architettura del valore
I risultati dei benchmark sono la parte più facile da comunicare e probabilmente la parte meno rilevante per decidere se questa direzione ha futuro in produzione. Ciò che conta di più è una tesi che Huang ha formulato verso la fine della sua presentazione e che merita di essere esaminata con attenzione.
Il suo argomento è che l'intelligenza generale in robotica arriverà prima sotto forma di un agente che orchestra tecnologie convenzionali e policy specializzate, non come un modello unico che impara tutto da zero. Per l'osservatore esterno, il risultato sembra intelligenza generale perché l'agente coordina tutto in modo coerente. Sotto, ci sono componenti ben definiti che fanno ciò che sanno fare.
Questo ha implicazioni su come si distribuisce il valore nel settore. NVIDIA non sta scommettendo solo sulla vendita di capacità di calcolo per addestrare robot. Sta scommettendo sul fatto che il processo di sviluppo — simulazione, generazione di codice, validazione e reconfigurazione dei robot — passi attraverso la sua infrastruttura software. Isaac Lab-Arena, il motore fisico Newton, le librerie di robotica: se gli agenti che generano codice per robot utilizzano per impostazione predefinita quegli strumenti perché sono disponibili e ben documentati, NVIDIA diventa il livello di sviluppo standard del settore, non solo il fornitore di chip.
Vi è inoltre un argomento di retroalimentazione che Huang ha citato esplicitamente: il codice generato dagli agenti per i robot può diventare dati di addestramento per i modelli successivi. Se questo si concretizza, la robotica agentica non si limita a risolvere il problema odierno della scarsità di dati. Crea un meccanismo per generarli su larga scala, con alta qualità e struttura semantica chiara, che i dati delle dimostrazioni umane raramente posseggono.
Il rischio reale non è che l'approccio non funzioni in simulazione. Ci sono già prove che funziona. Il rischio è quello che accompagna sempre le scommesse tecnicamente corrette ma premature nel loro trasferimento al mondo fisico: che la distanza tra il laboratorio e la linea di produzione consumi il margine di vantaggio prima che il mercato possa validarla. I produttori che stanno valutando questo approccio non stanno acquistando un articolo scientifico con un tasso di successo del 99% in simulazione. Stanno acquistando affidabilità dimostrata nel loro stabilimento, con i loro robot, i loro materiali e le loro tolleranze. Quella validazione è ancora in sospeso, ed è quella che deciderà se questa direzione diventerà uno standard o un'ulteriore iterazione nel percorso verso qualcosa che deve ancora essere definito.