La IA física en el campo no tiene problema de tecnología, tiene un problema de diseño
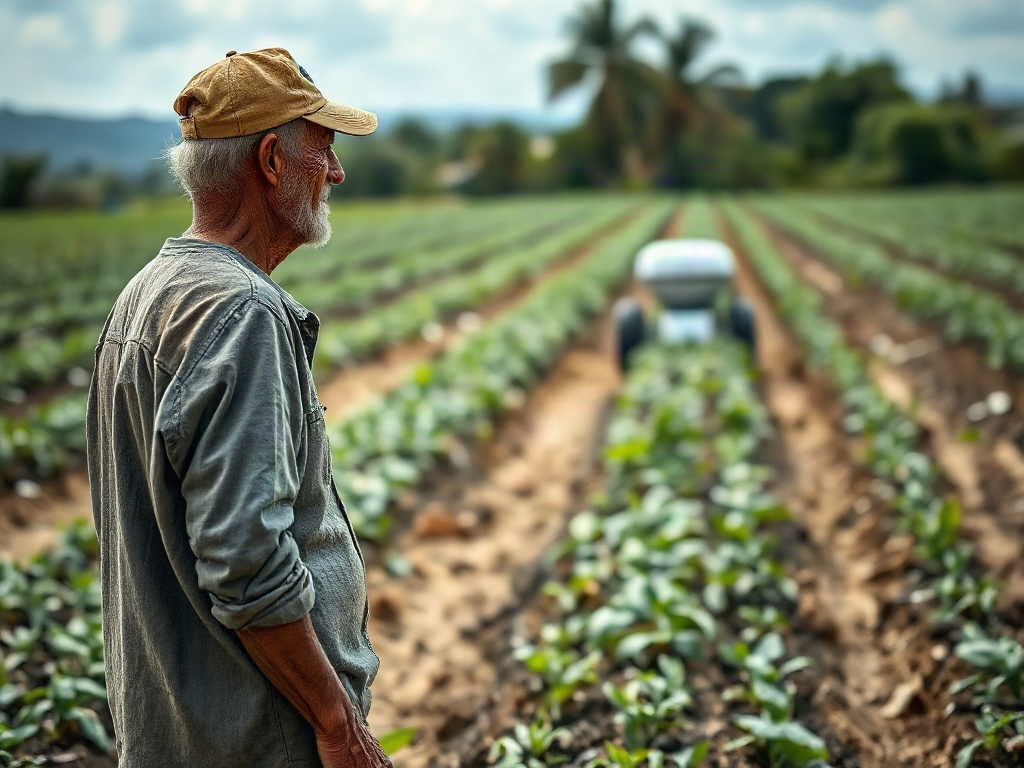
Hay una conversación que ocurre en casi todos los congresos de agroindustria del momento: la promesa de los robots autónomos que cosechan, rocían, monitorean y transportan sin que ningún trabajador humano tenga que doblar la espalda bajo el sol. Las presentaciones son impecables. Los renders, impresionantes. Y en la sala, sentadas cerca de la salida, están las personas cuyo trabajo se está automatizando, que nadie invitó a co-diseñar nada.
Eso no es un detalle. Es la fisura estructural que atraviesa toda la discusión sobre Inteligencia Artificial Física aplicada a la agricultura. La tecnología existe. Los marcos conceptuales se vuelven más sofisticados por mes. Pero la arquitectura de poder que decide quién diseña, quién se beneficia y quién carga con los costos de la transición permanece intacta, y en muchos casos, invisible.
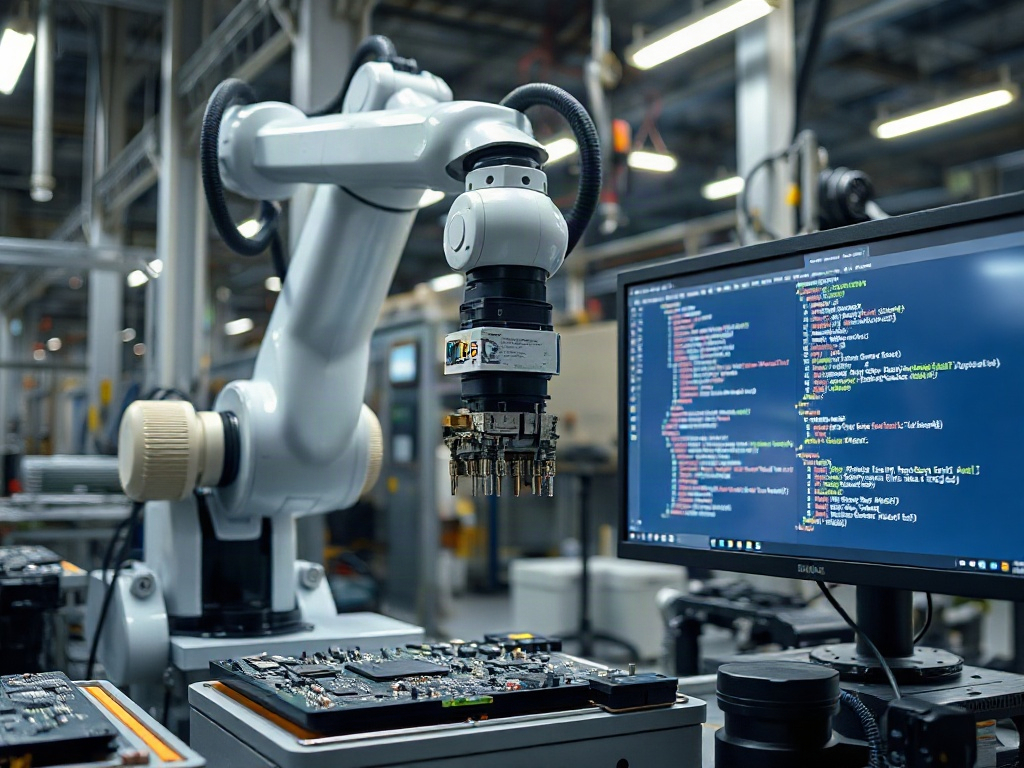
El capítulo publicado por la Biblioteca STATERA sobre aplicaciones agrícolas de IA Física describe con notable rigor el estado del arte: robots móviles que navegan entre surcos, drones que mapean estrés hídrico, manipuladores que detectan madurez en frutos individuales, flotas coordinadas que distribuyen tareas según disponibilidad de energía y ubicación. Es un mapa técnico serio. Pero como mapa, solo muestra el terreno que sus autores decidieron incluir.
Lo que no aparece en ese mapa también dice algo.
Cuando el algoritmo aprende de un solo punto de vista
La capa técnica del problema es, paradójicamente, la más fácil de nombrar. Cualquier sistema de visión computacional que aprende a distinguir una fruta madura de una inmadura, o una maleza de un cultivo, aprende de datos etiquetados por alguien. Ese alguien tiene un criterio, una experiencia, un contexto geográfico y una cultura agrícola específica. Si los conjuntos de datos de entrenamiento provienen mayoritariamente de granjas tecnificadas del norte global, de monocultivos con infraestructura RTK-GNSS, de condiciones de iluminación y geometría de fila que no existen en la agricultura familiar de América Latina o el África subsahariana, el sistema no falla en esas regiones por limitaciones técnicas. Falla porque fue entrenado con un punto de vista, y ese punto de vista nunca incluyó esos campos.
El propio capítulo de STATERA lo advierte con cuidado: "Los modelos entrenados en entornos limitados pueden tener un desempeño deficiente cuando se despliegan bajo condiciones agrícolas desconocidas." La frase es correcta y, al mismo tiempo, insuficiente. No es solo un problema de generalización estadística. Es un problema de quién estaba en la sala cuando se decidió qué datos recolectar, qué síntomas etiquetar como enfermedad y qué variedad de cultivo era el caso base del modelo.
La desigualdad no se automatiza en el momento del despliegue. Se automatiza en el momento del diseño. Y el diseño de sistemas de IA agrícola ocurre, en su mayor parte, en laboratorios universitarios y startups del Valle de Silicon o de Wageningen, con acceso a granjas piloto seleccionadas por su infraestructura, no por su representatividad del mundo real de la producción alimentaria global. El resultado es una tecnología que mejora la productividad donde ya hay productividad, y que llega tarde, cara o directamente irrelevante donde más se necesita.
Esto no es una crítica moral a los ingenieros individuales. Es una observación estructural sobre los incentivos del ecosistema que financia la investigación, que elige los casos de uso, que decide qué es un problema suficientemente grande como para merecer solución.
La geometría de quién queda fuera
La arquitectura de capital social en la cadena de valor de la IA agrícola sigue un patrón que vale la pena hacer visible. En el nodo central están los proveedores de tecnología, los inversores de riesgo, las grandes cooperativas y los retailers que pueden exigir trazabilidad y certificación. En la periferia están los productores pequeños y medianos, los trabajadores agrícolas estacionales, las comunidades indígenas con conocimiento territorial acumulado por generaciones y los técnicos de campo que actualmente interpretan los síntomas que ningún modelo ha aprendido a leer.
La narrativa dominante sobre la escasez de mano de obra, que el capítulo de STATERA presenta como uno de los motores de la automatización, merece ser leída con precisión quirúrgica. Escasez no es un fenómeno neutro. En muchas regiones, la escasez de trabajadores agrícolas es el resultado de décadas de salarios deprimidos, condiciones de trabajo insostenibles y ausencia de protección social. Automatizar esa escasez sin haber resuelto sus causas no elimina la vulnerabilidad sistémica; la traslada. Los trabajadores que pierden ingresos estacionales en un contexto donde no existe red de protección no desaparecen del problema. Regresan a él en otra forma, como consumidores con menos poder adquisitivo, como comunidades rurales que se vacían, como presión migratoria que ninguna junta directiva de agroindustria quiere reconocer como externalidad propia.
Hay una razón por la que el capítulo técnico dedica un apartado completo a la economía de los robots agrícolas y, sin embargo, no incluye ningún análisis del impacto distributivo de esa economía. El modelo de retorno sobre la inversión que presenta es internamente correcto: calcula horas productivas, costo por hectárea tratada, ahorro en insumos. Lo que no calcula es el costo que absorben otros actores del sistema cuando esa eficiencia se captura en un nodo y no se distribuye.
La utilización estacional es el talón de Aquiles financiero del modelo. Un robot cosechador que opera durante cuatro semanas al año y permanece inactivo el resto necesita modelos de Robótica como Servicio, copropiedad o despliegue multi-cultivo para tener sentido económico. Esos modelos existen en el papel. Pero su escalamiento real depende de infraestructura logística, conectividad, capacidad técnica local y confianza institucional, variables que son abundantes exactamente donde la tecnología ya funciona bien y escasas exactamente donde podría ser más transformadora.
La inteligencia periférica que el modelo no captura
Hay un tipo de conocimiento que los sistemas de IA agrícola actuales no pueden procesar porque no ha sido digitalizado, ni etiquetado, ni incorporado a ningún conjunto de datos de entrenamiento. Es el conocimiento que vive en la periferia del sistema: en el jornalero que sabe por el olor del suelo si va a llover, en la agricultora que distingue el estadio de madurez de una variedad local que no existe en ningún catálogo comercial, en el técnico de extensión agrícola que lleva quince años mapeando mentalmente los patrones de plaga en una cuenca específica.
Ese conocimiento no es folclore. Es inteligencia operativa acumulada bajo condiciones de incertidumbre real, con recursos limitados y consecuencias directas sobre la subsistencia. Es exactamente el tipo de inteligencia que los sistemas físicos de IA necesitan para funcionar en entornos no estructurados, que es precisamente lo que la agricultura del mundo real es.
El problema no es que los ingenieros ignoren este conocimiento porque les resulta inferior. El problema es que la arquitectura del sistema de desarrollo tecnológico no tiene mecanismos para incorporarlo. No hay un proceso estandarizado para que un técnico de campo en Oaxaca o en Senegal etiquete datos de entrenamiento con su criterio agronómico local. No hay una interfaz de retroalimentación que permita que un agricultor corrija el diagnóstico de un modelo cuando el modelo se equivoca. No hay un modelo de negocio que pague por ese conocimiento de la misma manera que paga por el hardware o el software de visión.
El capítulo de STATERA reconoce que "el aprendizaje basado en datos puede mejorar el rendimiento de los robots agrícolas a través de observaciones acumuladas y resultados de ejecución." Eso es cierto. Pero los datos acumulados solo capturan lo que el sistema ya fue diseñado para observar. La inteligencia que está fuera de ese campo visual no mejora el modelo. Simplemente no existe para él.
Lo que revela la arquitectura del sistema, no la tecnología
La IA Física agrícola no es una tecnología fallida. Es una tecnología que funciona bien dentro de los límites de su propio diseño, y que tiene el potencial de ser transformadora si se modifica quién participa en ese diseño. La diferencia entre esas dos versiones no es técnica. Es estructural.
Los gemelos digitales de granjas, las flotas coordinadas de robots, los sistemas de rociado de precisión que activan boquillas individuales con sincronización al milímetro, todo eso representa una capacidad genuina de aumentar la inteligencia operativa en la producción alimentaria. Pero esa capacidad fluye hacia donde ya existe capital para adoptarla, infraestructura para sostenerla y poder de negociación para exigir que funcione.
La homogeneidad de los equipos de diseño no es un problema de representación simbólica. Es un problema de puntos ciegos operativos que se codifican en los modelos antes de que nadie los vea. Un equipo que piensa igual comparte las mismas suposiciones sobre qué campo es el caso base, qué variedad de cultivo es la estándar, qué condición lumínica es la normal y qué agricultor es el usuario modelo. Esas suposiciones no se declaran en ningún documento de requisitos. Se incorporan silenciosamente en cada decisión de diseño.
La fragilidad de un sistema de IA agrícola diseñado desde un solo punto de vista no se manifiesta en el laboratorio. Se manifiesta en el tercer mes de despliegue, cuando el modelo encuentra una variedad local que nunca vio, o cuando el suelo tiene una composición que ningún sensor del conjunto de entrenamiento había medido, o cuando la geometría de las hileras no coincide con ninguna de las geometrías que el sistema aprendió a interpretar. En ese momento, el robot se detiene, o toma la decisión equivocada, o requiere intervención humana. Y la intervención humana disponible en ese campo no tiene el entrenamiento para entender por qué falló el sistema.
La inteligencia periférica no es un complemento amable de la IA agrícola. Es la condición de su confiabilidad en el mundo real. Los sistemas que se diseñen sin incorporar esa inteligencia desde el inicio no serán reemplazados por versiones mejores. Serán abandonados por los usuarios que más podrían beneficiarse de ellos, y adoptados exclusivamente por los usuarios que ya tenían suficiente capital para compensar sus limitaciones.
Eso no resuelve el problema de la escasez laboral ni el de la sostenibilidad alimentaria global. Solo concentra los beneficios de la automatización donde ya se concentraban los beneficios de todo lo anterior. La arquitectura del poder no cambió. Solo se volvió más eficiente dentro de sus propios límites.