农业领域的实体人工智能没有技术问题,它有设计问题
在当下几乎所有农业综合产业大会上,都会出现这样一场对话:关于自主机器人的承诺——它们能够收割、喷洒、监测和运输,无需任何工人在烈日下弯腰劳作。演示文稿无可挑剔,渲染效果令人叹为观止。而坐在会场靠近出口处的,是那些工作正在被自动化的人——没有人邀请他们参与任何设计。
这不是一个细节问题。这是贯穿整个实体人工智能应用于农业这一讨论的结构性裂缝。技术已然存在。概念框架每个月都在变得更加复杂精密。但决定谁来设计、谁从中受益、谁来承担转型成本的权力架构依然完好无损,而且在许多情况下,仍不可见。
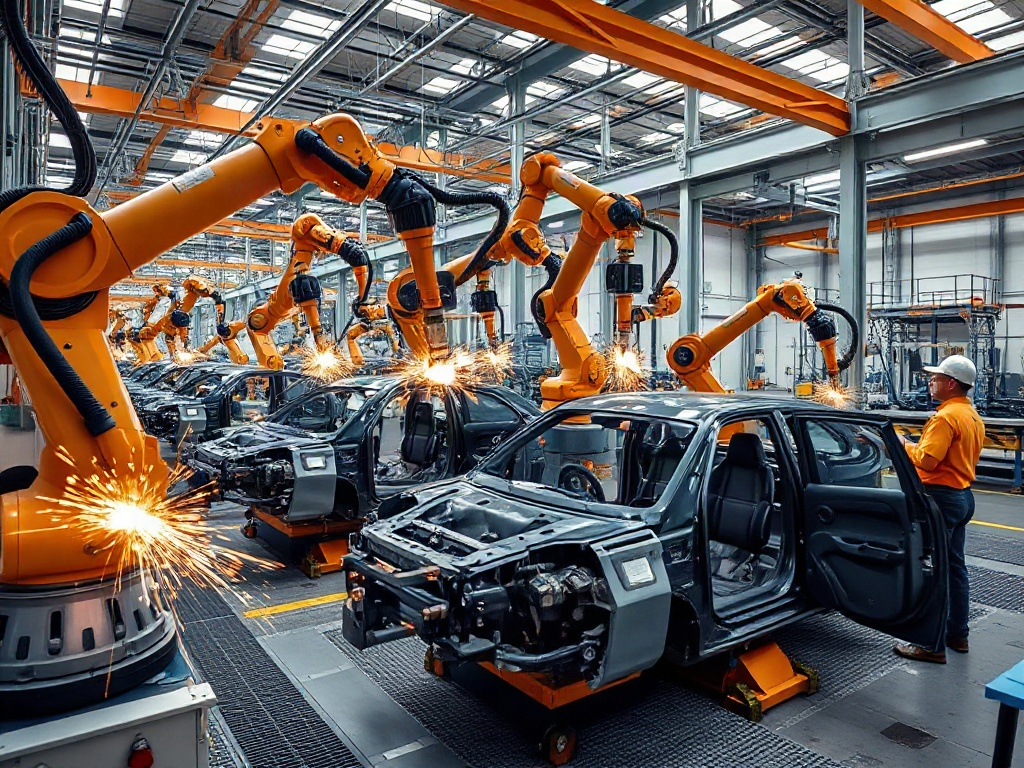
STATERA图书馆发布的关于实体人工智能农业应用的章节以相当严谨的笔墨描述了技术前沿现状:能够在田垄间导航的移动机器人、绘制水分胁迫图的无人机、能检测单个果实成熟度的机械臂、根据能源可用性和位置分配任务的协调机群。这是一份严肃的技术地图。但作为地图,它只展示了作者决定纳入的地形。
地图上没有呈现的内容,同样说明了一些问题。
当算法只从单一视角中学习
这一问题的技术层面,吊诡的是,反而是最容易点名的。任何学习区分成熟果实与未成熟果实、或区分杂草与作物的计算机视觉系统,都是从某人标注的数据中学习的。这个"某人"有其自身的判断标准、经验、地理背景和特定的农业文化。如果训练数据集主要来自全球北方技术化农场、来自配备RTK-GNSS基础设施的单一作物种植区、来自拉丁美洲家庭农业或撒哈拉以南非洲地区根本不存在的光照条件和行距几何结构,那么该系统在这些地区的失败并非源于技术局限。它失败是因为它从单一视角中被训练出来,而那个视角从未包含这些田野。
STATERA章节本身也谨慎地提出了这一点:"在有限环境中训练的模型在未知农业条件下部署时,可能表现不佳。"这句话是正确的,同时也是不充分的。这不仅仅是一个统计泛化问题。这是一个关于谁在决定收集哪些数据、将哪些症状标注为疾病、哪个作物品种作为模型基准案例时坐在会议室里的问题。
不平等并非在部署时被自动化。它在设计时就被自动化了。 而农业人工智能系统的设计,大部分发生在硅谷或瓦赫宁根的大学实验室和初创公司中,这些地方能够进入的示范农场之所以被选中,是因为其基础设施,而非因为其对全球粮食生产现实的代表性。结果是这样一种技术:它在已有生产力的地方提升生产力,而在最需要它的地方,它要么来得太晚、太贵,要么根本毫无用处。
这不是对个别工程师的道德批判。这是对生态系统激励机制的结构性观察——这个生态系统资助研究、选择使用场景、决定什么问题足够重大到值得被解决。
被排除在外的群体的几何结构
农业人工智能价值链中的社会资本架构遵循着一种值得揭示的规律。处于中心节点的是技术供应商、风险投资人、大型合作社以及能够要求可追溯性和认证的零售商。处于边缘的是中小企业规模的生产者、季节性农业工人、拥有世代积累的地方性知识的原住民社区,以及目前正在解读没有任何模型学会读取的症状的农业技术推广人员。
STATERA章节将劳动力短缺问题呈现为自动化驱动力之一,这一关于劳动力短缺的主导叙事值得以外科手术般的精准加以审视。短缺不是一种中性现象。在许多地区,农业工人的短缺是数十年来工资被压低、工作条件难以为继、缺乏社会保障的结果。在没有解决这些根本原因的情况下就将这种短缺自动化,并不能消除系统性脆弱性,而只是将其转移。在没有保护网络的背景下失去季节性收入的工人并不会从问题中消失——他们以另一种形式回归:购买力下降的消费者、空心化的农村社区、没有任何农业综合产业董事会愿意承认为自身外部性的移民压力。
这就是为什么该技术章节专门用一个小节讨论农业机器人经济学,却没有包含对这种经济学的分配影响分析。章节中呈现的投资回报模型在内部逻辑上是正确的:它计算了生产性工时、每公顷处理成本、投入品节约。它没有计算的是,当这种效率在某个节点被获取而未被分配时,系统中其他参与者所承担的成本。
季节性利用率是这一模式的财务致命弱点。 一台每年运行四周、其余时间闲置的收割机器人,需要采用机器人即服务、共同所有权或多作物部署等模式,才能在经济上站得住脚。这些模式在纸面上存在。但其真正的规模化依赖于物流基础设施、连通性、当地技术能力和机构信任——而这些变量恰恰在技术本已运转良好的地方丰沛,在技术最具变革潜力的地方匮乏。
模型无法捕捉的边缘智慧
有一类知识是当前农业人工智能系统无法处理的,因为它从未被数字化、标注,也从未被纳入任何训练数据集。这是生活在系统边缘的知识:存在于通过泥土气味就能判断是否将要下雨的日薪工人身上,存在于能够辨别任何商业目录中都不存在的某个地方品种的成熟阶段的女农人身上,存在于在某个特定流域心中默默绘制了十五年病虫害规律图的农业推广技术人员身上。
这些知识不是民间传说。这是在真实不确定性条件下、以有限资源、并对生计产生直接影响的情境中积累的操作性智慧。这恰恰是实体人工智能系统在非结构化环境中运作所需的那类智慧——而现实世界的农业恰恰就是这样的非结构化环境。
问题不在于工程师们轻视这些知识,认为它低人一等。问题在于技术开发系统的架构没有纳入这些知识的机制。没有标准化流程让瓦哈卡或塞内加尔的农业技术员用他们的本地农艺判断来标注训练数据。没有反馈界面允许农民在模型出错时纠正模型的诊断。没有任何商业模式能够像支付硬件或计算机视觉软件那样,支付这些知识的报酬。
STATERA章节承认"基于数据的学习可以通过积累的观察和执行结果提升农业机器人的性能。"这是事实。但积累的数据只能捕捉系统最初被设计来观察的内容。处于那个视野之外的智慧并不能改进模型——它对模型而言根本不存在。
系统架构揭示的,不是技术本身
农业实体人工智能不是一种失败的技术。它是一种在自身设计边界内运转良好的技术,如果修改参与设计的人员构成,它具备变革性潜力。这两个版本之间的差异不是技术性的。而是结构性的。
农场数字孪生、协调机器人机群、以毫米级同步精度激活单个喷嘴的精准喷洒系统——所有这些代表着在粮食生产中真正提升操作智能的能力。但这种能力流向的地方,恰恰是已经拥有资本来采用它、拥有基础设施来维持它、拥有谈判权来要求它正常运转的地方。
设计团队的同质性不是象征性代表问题。这是操作盲点问题,而这些盲点在任何人看到之前就已被编码进了模型。一个思维方式相同的团队共享着同样的假设——什么样的田野是基准案例、什么品种是标准品种、什么光照条件是正常的、什么样的农民是目标用户。这些假设不会在任何需求文档中被明确声明。它们被悄无声息地融入每一个设计决策之中。
从单一视角设计出来的农业人工智能系统的脆弱性,不会在实验室中显现。它会在部署后的第三个月显现:当模型遭遇从未见过的本地品种时,当土壤成分是训练集中任何传感器都未曾测量过的时,当田间行距的几何结构与系统学会解读的任何几何结构都不匹配时。在那一刻,机器人停下来,或做出错误决策,或需要人工干预。而那片田野中可用的人工干预,没有经过训练来理解系统为何失效。
边缘智慧不是农业人工智能的友善补充。它是农业人工智能在现实世界中可靠运行的前提条件。 没有从一开始就纳入这些智慧而设计出来的系统,不会被更好的版本所取代。它们将被最能从中受益的用户所抛弃,并被那些已经拥有足够资本来弥补其局限性的用户所独家采用。
这既不能解决劳动力短缺问题,也不能解决全球粮食可持续性问题。它只会将自动化的收益集中在那些原本就集中着一切既有收益的地方。权力架构没有改变——它只是在自身边界内变得更加高效了。