当编程机器人不再是数据问题
过去三年涌入机器人领域的大多数资本背后,都隐含着一个赌注:只要积累足够多的人类示范数据,机器人就能学会人类所做的事情。这一逻辑之所以令人信服,是因为它曾经奏效过——在语言模型领域。但机器人技术不是文本,这一差异正开始让那些以为同一套方法能产出同一结果的人付出沉重代价。
加州大学伯克利分校与英伟达在2026年机器人学习大会上发布的成果,并非对这一范式的渐进式改良,而是对其的彻底突破。他们提出的"智能体机器人学(robótica agéntica)"认为,问题的根源不在于数据匮乏,而在于此前一直在解决错误的瓶颈。
无人愿意宣布的瓶颈
肯·戈德堡(Ken Goldberg)是加州大学伯克利分校机器人学教授、Ambi Robotics联合创始人,多年来一直与西门子、博世等工业制造商保持合作。他的诊断直截了当:模仿学习在某种程度上是有效的,但这个临界点来得比投资者预期的快得多。"一开始用数据能取得不错的表现,但随后事情就会出错。于是加入更多数据,然而其他问题又冒出来了,"他描述道。系统是否正在收敛,没有明确信号。
问题的根源是结构性的。语言模型是用人类迄今产生的全部文本中相当大的一部分来训练的。而现有任何机器人数据集都无法达到这样的规模,通过在真实环境中录制人类示范来构建这样的数据集,是一个缓慢且昂贵的过程。那些以"数据能解决一切"为前提筹集资金的企业,如今面对一个令人不安的问题:还差多远,而那个"足够多"究竟能否在市场耐心耗尽之前到来。
更使诊断复杂化的是,模仿学习产生的系统难以被轻易审查。这些系统是高平均性能的黑箱,可能在最不合时宜的时刻以不可预测的方式失败。对于工业应用而言,"失败"可能意味着生产线停摆或人员受伤,这样的风险特征很难在运营委员会面前得到辩护。
以代码取代数据:伯克利与英伟达提出的转向
智能体机器人学将数据稀缺问题转化为代码生成问题。而对于后者,语言模型确实具备足够的规模。
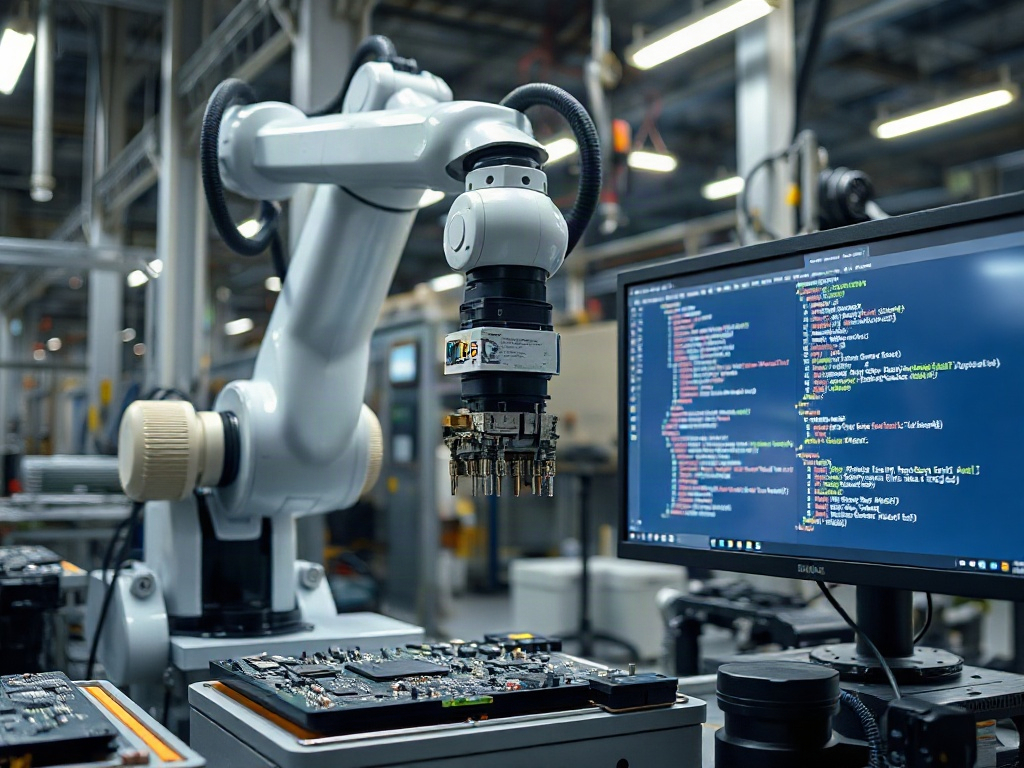
其工作流程如下:一个自然语言目标——例如将产品装入袋中,或将注射器放入废物容器——被分解为若干子任务。专业代码智能体(能够自主编写、测试和修改软件的AI系统)接管各自负责的具体功能:视觉感知、姿态估计、运动规划、夹爪控制。每个智能体调用已有的机器人学库——这些库代表着数十年来在目标分类、轨迹规划和运动控制领域的积累。生成的代码在仿真环境中运行,智能体识别失败原因,调整参数,再次迭代。
伯克利测试中记录的结果显示,所评估任务的成功率高达99%,而同等任务下模仿学习方法的成功率仅约为20%。差距绝非微不足道。
值得关注的一个维度是仿真本身。将仿真环境配置得足够精确,使生成的代码能在物理世界中发挥作用,历来是一项劳动密集型的手工任务。戈德堡团队展示的成果是:一个智能体能够自动调整仿真器的参数——光照、几何形状、背景——使其与真实环境的视频相吻合。戈德堡的描述颇为生动:"让我们不寒而栗。两者并排比较,很难分辨仿真与视频的区别。"这并不能解决物理迁移问题,但消除了一层此前需要专家才能完成的工程工作。
该架构还包含一个质量控制层:一个对抗性智能体,专门负责找出其他智能体所产出内容中的缺陷。英伟达机器人工程总监斯宾塞·黄(Spencer Huang)以务实的态度描述了这一机制:"大家都知道AI智能体可能产生垃圾内容。为了对抗这一点,我们采用了对抗性配置。"这是一种将怀疑精神内嵌于流程之中的方式——不是作为外部纠错,而是作为开发周期本身的组成部分。
在制造业中有效的,以及在外部仍然行不通的
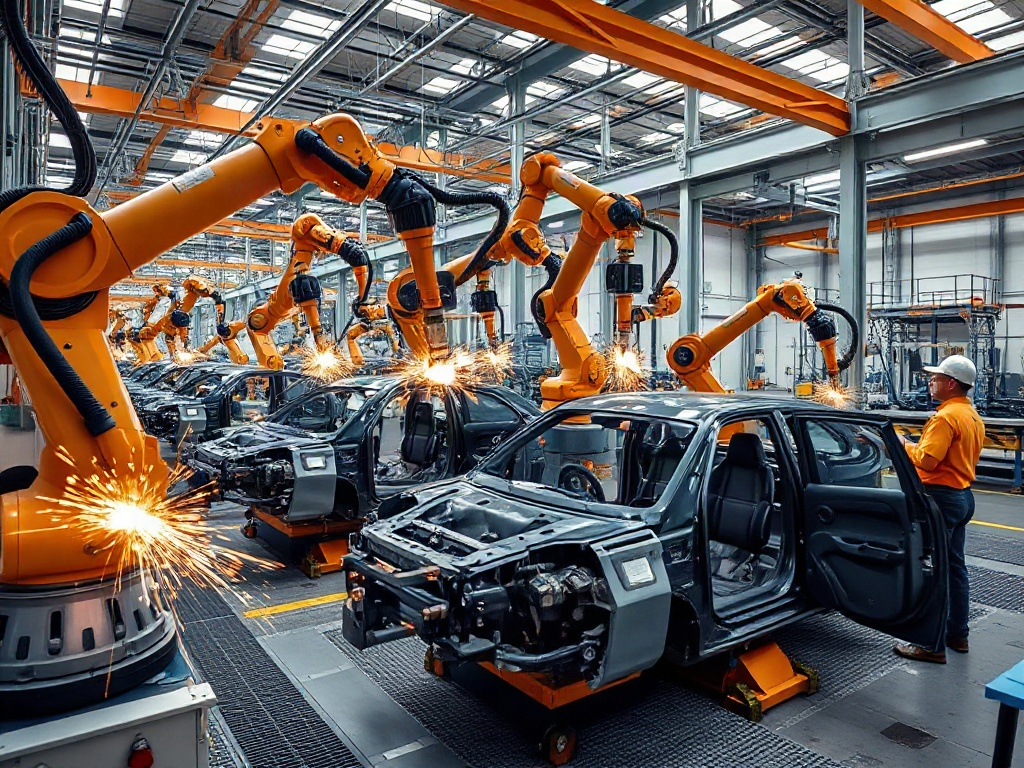
从这项研究中浮现出的最具体案例,涉及英伟达GPU主板的台湾制造商纬创(Wistron)。当该公司在生产线上引入一款新产品时,重新配置单台机器人至少需要八小时。而有了智能体机器人学,黄表示这一时间可以缩短至一两分钟。如果这一数据在实际生产中得以验证,影响将不仅限于运营层面,更是财务层面的:缩短产线准备时间、提高设备利用率,以及对产品变更的响应能力——而这类变更目前需要提前数周进行规划。
黄引用的另一个例子来自半导体行业,其中某些装配工序要求以0.3毫米的精度放置元件。这是编程良好的传统工业机器人可以达到的精度阈值,却是当前人形机器人平台无法以该行业所要求的可重复性达到的阈值。对于这类应用场景,智能体机器人学提供了通用人形机器人路线迄今尚未实现的东西:在极端精度条件下可验证的可靠性。
正是在这里,Alphabet旗下机器人公司Intrinsic的科学总监托尔斯滕·克勒格尔(Torsten Kroeger)以更为严格的技术立场踩下了刹车。他的论点并非认为这一方法有误,而是指出任何现有的物理引擎都没有解决物理接触问题。仿真看起来可以与现实完全一致,但这无法保证机械行为——摩擦、形变、冲击——能以机器人在真实工业条件下操作物体所需的精度来建模。这一差距不是靠模型的智能体能力来弥合的,而是靠仿真器的物理精度来弥合的。而在这一方面,整个领域仍然落后。
克勒格尔还提出了一个在业界从概念上解决之前便将产生监管后果的问题:如果智能体自主生成并修改机器人代码,如何确保这些代码始终是安全的。他的论点并非认为智能体会失败,而是随着自主修改规模的增长,人工审查将越来越难以实现。这是对齐问题在物理制造领域的映射,其影响远比纯软件层面更为具体。
最有价值的论点不是性能,而是价值的架构
基准测试结果是最容易传达的部分,也很可能是判断这一方向是否具备量产前景时最不重要的部分。更重要的是黄在演讲接近尾声时阐述的一个论点,值得仔细审视。
他的论点是:机器人领域的通用智能,将首先以一个协调传统技术与专业策略的智能体形态出现,而非以一个从零开始学习一切的单一模型呈现。对外部观察者而言,结果看起来像是通用智能,因为智能体以连贯的方式协调了一切。在此之下,是界定明确的各个组件在各司其职。
这对价值在行业中如何分配具有深远影响。英伟达不仅仅在押注出售用于训练机器人的算力,还在押注机器人的开发流程——仿真、代码生成、验证与重新部署——将通过其软件基础设施来完成。Isaac Lab-Arena、牛顿物理引擎、机器人学库:如果为机器人生成代码的智能体默认使用这些工具——因为它们是现成可用且文档齐全的——英伟达将成为业界标准的开发层,而不仅仅是芯片供应商。
此外,黄还明确提及了一个反馈循环论点:由智能体为机器人生成的代码,可以成为后续模型的训练数据。如果这一点成立,智能体机器人学不仅解决了当下的数据稀缺问题,还创造了一种大规模、高质量、具备清晰语义结构地生成数据的机制——而人类示范数据鲜有具备这些特征。
真正的风险不在于这一方法在仿真中行不通——已有证据表明它是有效的。风险在于所有技术上正确却在向物理世界迁移时操之过急的押注所共同面临的那个问题:从实验室到生产线之间的距离,可能在市场完成验证之前就已消耗掉所有的先发优势。那些正在评估这一方案的制造商,买的不是一篇仿真成功率99%的论文,而是在他们自己的工厂、用他们自己的机器人、材料和公差标准所得到的可靠性验证。这一验证尚未到来,而它的结果,将最终决定这一方向究竟会成为行业标准,还是通往某个仍待定义之物的漫长旅途中的又一次迭代。