La physique de l'IA dans les champs n'a pas un problème technologique, elle a un problème de conception
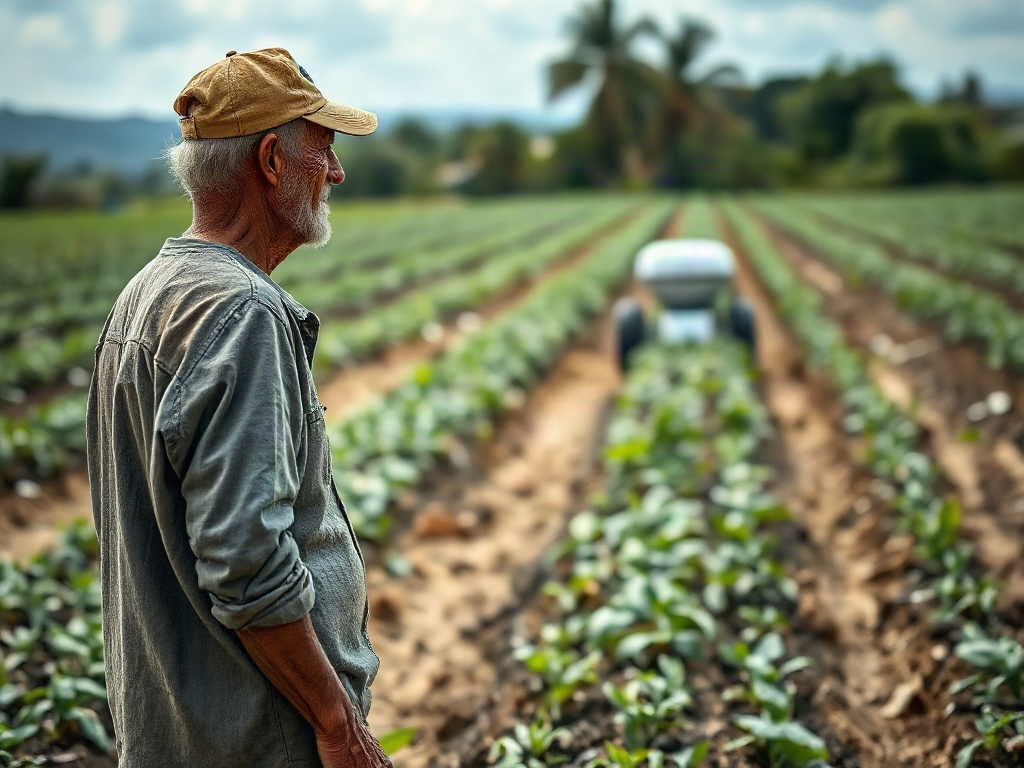
Il existe une conversation qui se tient dans presque tous les congrès de l'agroindustrie en ce moment : la promesse des robots autonomes qui récoltent, aspergent, surveillent et transportent sans qu'aucun travailleur humain n'ait à courber le dos sous le soleil. Les présentations sont impeccables. Les rendus, impressionnants. Et dans la salle, assises près de la sortie, se trouvent les personnes dont le travail est en cours d'automatisation, que personne n'a invitées à co-concevoir quoi que ce soit.
Ce n'est pas un détail. C'est la fissure structurelle qui traverse toute la discussion sur l'Intelligence Artificielle Physique appliquée à l'agriculture. La technologie existe. Les cadres conceptuels se perfectionnent de mois en mois. Mais l'architecture du pouvoir qui décide qui conçoit, qui en bénéficie et qui supporte les coûts de la transition demeure intacte, et dans bien des cas, invisible.
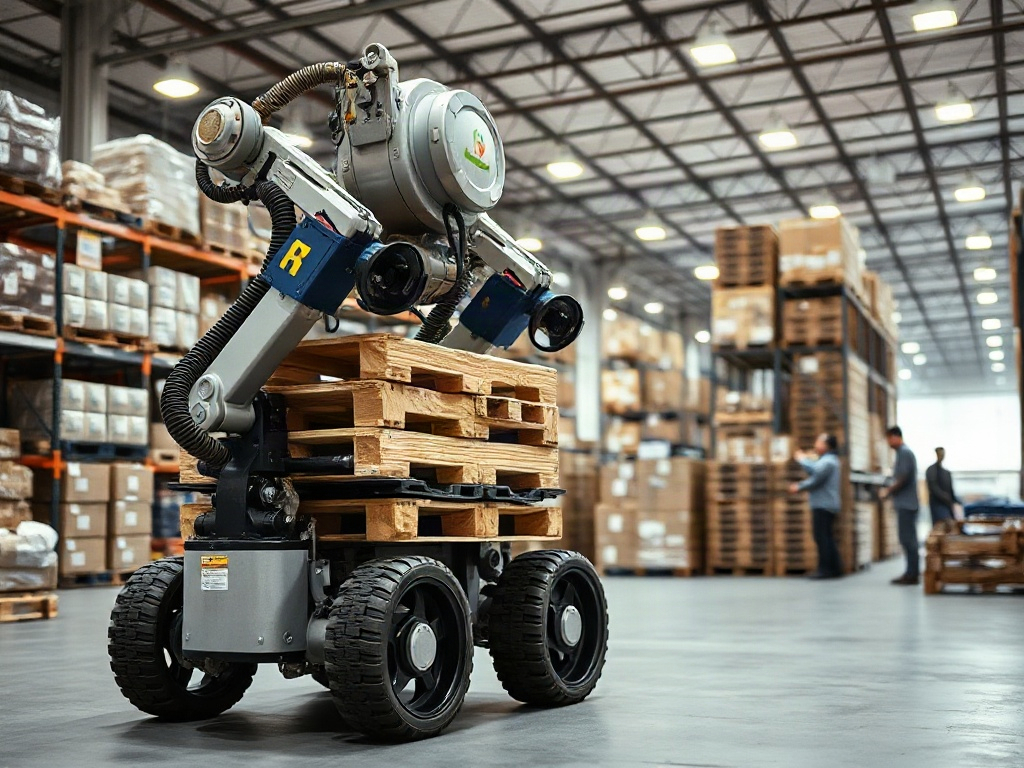
Le chapitre publié par la bibliothèque STATERA sur les applications agricoles de l'IA Physique décrit avec une rigueur remarquable l'état de l'art : des robots mobiles qui naviguent entre les sillons, des drones qui cartographient le stress hydrique, des manipulateurs qui détectent la maturité de fruits individuels, des flottes coordonnées qui répartissent les tâches selon la disponibilité énergétique et la localisation. C'est une carte technique sérieuse. Mais comme toute carte, elle ne montre que le terrain que ses auteurs ont décidé d'y inclure.
Ce qui n'apparaît pas sur cette carte dit quelque chose, lui aussi.
Quand l'algorithme n'apprend que d'un seul point de vue
La couche technique du problème est, paradoxalement, la plus facile à nommer. Tout système de vision computationnelle qui apprend à distinguer un fruit mûr d'un fruit immature, ou une mauvaise herbe d'une culture, apprend à partir de données étiquetées par quelqu'un. Cette personne possède un critère, une expérience, un contexte géographique et une culture agricole spécifiques. Si les jeux de données d'entraînement proviennent majoritairement de fermes technifiées du Nord global, de monocultures dotées d'une infrastructure RTK-GNSS, de conditions d'éclairage et de géométrie de rangées qui n'existent pas dans l'agriculture familiale d'Amérique latine ou d'Afrique subsaharienne, le système n'échoue pas dans ces régions en raison de limitations techniques. Il échoue parce qu'il a été entraîné selon un point de vue, et ce point de vue n'a jamais intégré ces champs.
Le chapitre STATERA lui-même le signale avec soin : « Les modèles entraînés dans des environnements limités peuvent présenter de mauvaises performances lorsqu'ils sont déployés dans des conditions agricoles inconnues. » La formulation est exacte et, en même temps, insuffisante. Il ne s'agit pas seulement d'un problème de généralisation statistique. C'est un problème de savoir qui se trouvait dans la salle au moment où l'on a décidé quelles données collecter, quels symptômes étiqueter comme maladie et quelle variété de culture constituait le cas de base du modèle.
L'inégalité ne s'automatise pas au moment du déploiement. Elle s'automatise au moment de la conception. Et la conception des systèmes d'IA agricole se déroule, pour l'essentiel, dans des laboratoires universitaires et des start-ups de la Silicon Valley ou de Wageningen, avec accès à des fermes pilotes sélectionnées pour leur infrastructure, non pour leur représentativité du monde réel de la production alimentaire mondiale. Le résultat est une technologie qui améliore la productivité là où il y en a déjà, et qui arrive trop tard, trop chère ou franchement hors de propos là où elle serait le plus nécessaire.
Ce n'est pas une critique morale adressée aux ingénieurs individuels. C'est une observation structurelle sur les incitations de l'écosystème qui finance la recherche, qui choisit les cas d'usage, qui décide quel problème est suffisamment important pour mériter une solution.
La géométrie de ceux qui restent à l'écart
L'architecture du capital social dans la chaîne de valeur de l'IA agricole suit un schéma qu'il vaut la peine de rendre visible. Au nœud central se trouvent les fournisseurs de technologie, les investisseurs en capital-risque, les grandes coopératives et les distributeurs qui peuvent exiger traçabilité et certification. En périphérie se trouvent les petits et moyens producteurs, les travailleurs agricoles saisonniers, les communautés autochtones dont la connaissance du territoire s'est accumulée sur des générations, et les techniciens de terrain qui interprètent actuellement les symptômes qu'aucun modèle n'a encore appris à lire.
Le récit dominant sur la pénurie de main-d'œuvre, que le chapitre STATERA présente comme l'un des moteurs de l'automatisation, mérite d'être lu avec une précision chirurgicale. La pénurie n'est pas un phénomène neutre. Dans de nombreuses régions, la pénurie de travailleurs agricoles est le résultat de décennies de salaires déprimés, de conditions de travail insoutenables et d'absence de protection sociale. Automatiser cette pénurie sans en avoir résolu les causes n'élimine pas la vulnérabilité systémique ; elle la déplace. Les travailleurs qui perdent des revenus saisonniers dans un contexte où il n'existe aucun filet de protection sociale ne disparaissent pas du problème. Ils y reviennent sous une autre forme : comme consommateurs au pouvoir d'achat réduit, comme communautés rurales qui se vident, comme pression migratoire qu'aucun conseil d'administration de l'agroindustrie ne veut reconnaître comme sa propre externalité.
Il y a une raison pour laquelle le chapitre technique consacre une section entière à l'économie des robots agricoles et n'inclut pourtant aucune analyse de l'impact distributif de cette économie. Le modèle de retour sur investissement qu'il présente est correct en lui-même : il calcule les heures productives, le coût par hectare traité, les économies sur les intrants. Ce qu'il ne calcule pas, c'est le coût que supportent les autres acteurs du système lorsque cette efficacité est captée dans un nœud et ne se distribue pas.
L'utilisation saisonnière est le talon d'Achille financier du modèle. Un robot récolteur qui fonctionne quatre semaines par an et reste inactif le reste du temps nécessite des modèles de Robotique en tant que Service, de copropriété ou de déploiement multi-culture pour avoir un sens économique. Ces modèles existent sur le papier. Mais leur mise à l'échelle réelle dépend d'une infrastructure logistique, de la connectivité, de capacités techniques locales et d'une confiance institutionnelle — des variables qui sont abondantes précisément là où la technologie fonctionne déjà bien, et rares précisément là où elle pourrait être la plus transformatrice.
L'intelligence périphérique que le modèle ne capture pas
Il existe un type de connaissance que les systèmes actuels d'IA agricole ne peuvent pas traiter parce qu'elle n'a jamais été numérisée, ni étiquetée, ni intégrée dans aucun jeu de données d'entraînement. C'est la connaissance qui vit en périphérie du système : chez le journalier qui sait à l'odeur du sol s'il va pleuvoir, chez l'agricultrice qui distingue le stade de maturité d'une variété locale qui n'existe dans aucun catalogue commercial, chez le technicien de vulgarisation agricole qui cartographie mentalement depuis quinze ans les schémas de ravageurs dans un bassin versant spécifique.
Ce savoir n'est pas du folklore. C'est une intelligence opérationnelle accumulée dans des conditions d'incertitude réelle, avec des ressources limitées et des conséquences directes sur la subsistance. C'est précisément le type d'intelligence dont les systèmes physiques d'IA ont besoin pour fonctionner dans des environnements non structurés — ce qu'est précisément l'agriculture du monde réel.
Le problème n'est pas que les ingénieurs ignorent ce savoir parce qu'ils le jugent inférieur. Le problème est que l'architecture du système de développement technologique ne dispose d'aucun mécanisme pour l'intégrer. Il n'existe pas de processus standardisé permettant à un technicien de terrain à Oaxaca ou au Sénégal d'étiqueter des données d'entraînement selon son propre critère agronomique local. Il n'existe pas d'interface de rétroaction permettant à un agriculteur de corriger le diagnostic d'un modèle quand ce modèle se trompe. Il n'existe pas de modèle économique qui rémunère ce savoir de la même façon qu'il rémunère le matériel ou le logiciel de vision.
Le chapitre STATERA reconnaît que « l'apprentissage fondé sur les données peut améliorer les performances des robots agricoles grâce à des observations cumulées et à des résultats d'exécution. » C'est vrai. Mais les données cumulées ne capturent que ce que le système a déjà été conçu pour observer. L'intelligence qui se situe hors de ce champ visuel n'améliore pas le modèle. Elle n'existe tout simplement pas pour lui.
Ce que révèle l'architecture du système, et non la technologie
L'IA Physique agricole n'est pas une technologie défaillante. C'est une technologie qui fonctionne bien dans les limites de sa propre conception, et qui a le potentiel d'être transformatrice si l'on modifie qui participe à cette conception. La différence entre ces deux versions n'est pas technique. Elle est structurelle.
Les jumeaux numériques de fermes, les flottes coordonnées de robots, les systèmes de pulvérisation de précision qui activent des buses individuelles avec une synchronisation au millimètre — tout cela représente une capacité réelle d'augmenter l'intelligence opérationnelle dans la production alimentaire. Mais cette capacité se dirige là où il existe déjà du capital pour l'adopter, une infrastructure pour la soutenir et un pouvoir de négociation pour exiger qu'elle fonctionne.
L'homogénéité des équipes de conception n'est pas un problème de représentation symbolique. C'est un problème d'angles morts opérationnels qui se codifient dans les modèles avant que quiconque les remarque. Une équipe qui pense de la même façon partage les mêmes suppositions sur quel terrain constitue le cas de base, quelle variété de culture est la norme, quelle condition lumineuse est la normale et quel agriculteur est l'utilisateur type. Ces suppositions ne sont déclarées dans aucun document de spécifications. Elles s'incorporent silencieusement dans chaque décision de conception.
La fragilité d'un système d'IA agricole conçu depuis un seul point de vue ne se manifeste pas en laboratoire. Elle se manifeste au troisième mois de déploiement, lorsque le modèle rencontre une variété locale qu'il n'a jamais vue, ou lorsque le sol présente une composition qu'aucun capteur du jeu d'entraînement n'avait mesurée, ou lorsque la géométrie des rangées ne correspond à aucune des géométries que le système a appris à interpréter. À ce moment-là, le robot s'arrête, ou prend la mauvaise décision, ou nécessite une intervention humaine. Et l'intervention humaine disponible dans ce champ n'a pas la formation nécessaire pour comprendre pourquoi le système a échoué.
L'intelligence périphérique n'est pas un complément aimable de l'IA agricole. Elle est la condition de sa fiabilité dans le monde réel. Les systèmes conçus sans intégrer cette intelligence dès le départ ne seront pas remplacés par de meilleures versions. Ils seront abandonnés par les utilisateurs qui pourraient en bénéficier le plus, et adoptés exclusivement par les utilisateurs qui disposaient déjà d'un capital suffisant pour compenser leurs limites.
Cela ne résout pas le problème de la pénurie de main-d'œuvre ni celui de la durabilité alimentaire mondiale. Cela ne fait que concentrer les bénéfices de l'automatisation là où se concentraient déjà les bénéfices de tout ce qui a précédé. L'architecture du pouvoir n'a pas changé. Elle est simplement devenue plus efficace dans ses propres limites.