Quand programmer des robots cesse d'être un problème de données
Il existe un pari implicite dans la majeure partie du capital qui a afflué vers la robotique au cours des trois dernières années : qu'avec suffisamment de démonstrations humaines, les robots apprendront à faire ce que les humains font. La logique est séduisante parce qu'elle a déjà fonctionné une fois, avec les modèles de langage. Mais la robotique n'est pas du texte, et cette différence commence à coûter cher à ceux qui ont supposé que la même recette produirait le même résultat.
Ce que l'UC Berkeley et NVIDIA ont présenté à la Conférence sur l'apprentissage en robotique de 2026 n'est pas une amélioration incrémentale de ce paradigme. C'est une rupture avec lui. La proposition qu'ils ont baptisée robotique agentique affirme que le problème n'était pas un manque de données, mais que l'on s'attaquait au mauvais goulot d'étranglement.
Le plateau que personne ne voulait annoncer
Ken Goldberg, professeur de robotique à l'UC Berkeley et cofondateur d'Ambi Robotics, travaille depuis des années avec des fabricants industriels, dont Siemens et Bosch. Son diagnostic est direct : l'apprentissage par imitation fonctionne jusqu'à un certain point, et ce point arrive plus vite que les investisseurs ne l'espéraient. « On obtient de bonnes performances avec les données au début, mais ensuite les choses tournent mal. On ajoute plus de données. Mais alors d'autres choses tournent mal », a-t-il décrit. Aucun signal clair n'indique que le système converge.
Le problème de fond est structurel. Les modèles de langage ont été entraînés sur une fraction significative de tout le texte que l'humanité a produit. Il n'existe aucun jeu de données en robotique qui se rapproche de cette échelle, et le constituer physiquement, à l'aide de démonstrations humaines enregistrées dans des environnements réels, est un processus lent et coûteux. Les entreprises qui ont levé des capitaux sur la prémisse que les données résoudraient tout se trouvent aujourd'hui face à une question inconfortable : combien de temps reste-t-il, et ce « suffisant » arrivera-t-il jamais avant que la patience du marché s'épuise.
Ce qui complique encore davantage le diagnostic, c'est que l'apprentissage par imitation produit des systèmes que personne ne peut auditer facilement. Ce sont des boîtes noires à haute performance moyenne qui peuvent échouer de manières imprévisibles au moment le moins opportun. Pour les applications industrielles, où « échouer » peut signifier une ligne de production arrêtée ou une blessure, ce profil de risque est difficile à justifier devant un comité opérationnel.
Du code à la place des données : le tournant que proposent Berkeley et NVIDIA
La robotique agentique transforme le problème de rareté des données en un problème de génération de code. Et pour cela, les modèles de langage disposent bien d'une échelle suffisante.
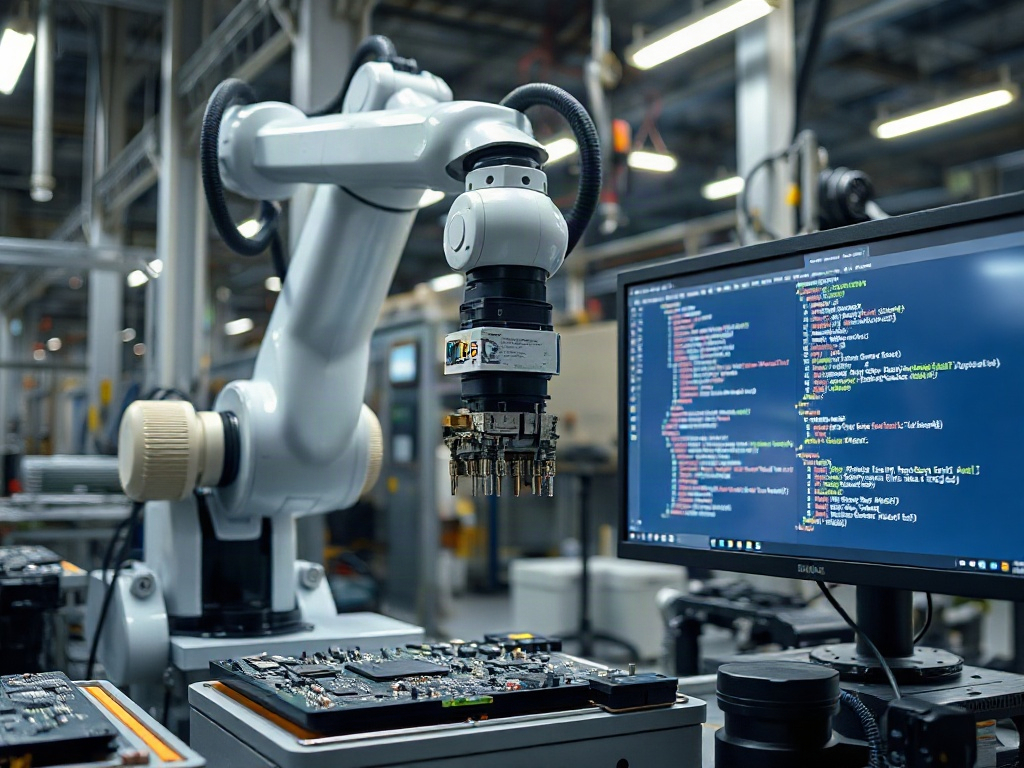
Le flux fonctionne ainsi : un objectif en langage naturel, comme emballer des produits dans un sac ou déposer des seringues dans un conteneur de déchets, est décomposé en sous-tâches. Des agents de code spécialisés — des systèmes d'IA autonomes capables d'écrire, de tester et de modifier des logiciels — prennent en charge des fonctions spécifiques : perception visuelle, estimation de pose, planification du mouvement, contrôle du préhenseur. Chaque agent utilise les bibliothèques de robotique déjà existantes, qui représentent des décennies de développement en classification d'objets, planification de trajectoires et contrôle de mouvement. Le code résultant est exécuté en simulation, les agents identifient les défaillances, ajustent les paramètres et itèrent à nouveau.
Le résultat documenté lors des tests de Berkeley a atteint des taux de réussite allant jusqu'à 99 % sur les tâches évaluées, contre environ 20 % pour les méthodes d'apprentissage par imitation sur ces mêmes tâches. L'écart n'est pas marginal.
Une dimension qui mérite attention est la simulation elle-même. Configurer un environnement simulé avec une précision suffisante pour que le code généré soit utile dans le monde physique a historiquement été une tâche manuelle intensive. Ce que Goldberg et son équipe ont montré, c'est qu'un agent peut ajuster les paramètres du simulateur — éclairage, géométrie, arrière-plan — pour qu'ils correspondent à une vidéo de l'environnement réel. La description de Goldberg était éloquente : « Ça nous a donné des frissons. En comparant côte à côte, il était très difficile de distinguer la simulation de la vidéo. » Cela ne résout pas le problème du transfert physique, mais élimine une couche de travail d'ingénierie qui nécessitait auparavant des spécialistes.
L'architecture comprend également une couche de contrôle qualité : un agent adversarial conçu pour trouver des failles dans ce qu'un autre agent produit. Spencer Huang, directeur de l'ingénierie en robotique chez NVIDIA, l'a décrit avec pragmatisme : « Nous savons tous que les agents d'IA peuvent produire des déchets. Pour contrecarrer cela, nous utilisons des configurations adversariales. » C'est une façon d'incorporer le scepticisme dans le processus lui-même, non pas comme une correction externe, mais comme une partie intégrante du cycle de développement.
Ce qui vaut en manufacturing et ce qui ne fonctionne pas encore dehors
Le cas le plus concret qui émerge de la recherche implique Wistron, fabricant taïwanais de cartes mères pour les GPU de NVIDIA. Lorsque cette entreprise intègre un nouveau produit à sa ligne, reconfigurer un seul robot prend au minimum huit heures. Avec la robotique agentique, Huang affirme que ce délai tombe à une ou deux minutes. Si ce chiffre se confirme en production réelle, l'impact n'est pas seulement opérationnel, il est financier : des lignes de production plus courtes, une meilleure utilisation des équipements, une capacité de réponse aux changements de produit qui nécessitent aujourd'hui une planification avec des semaines d'avance.
L'autre exemple cité par Huang est l'industrie des semi-conducteurs, où certains processus d'assemblage requièrent de placer des composants avec une précision de 0,3 millimètre. C'est un seuil que les robots industriels conventionnels, bien programmés, peuvent atteindre. Ce n'est pas un seuil que les plateformes de robots humanoïdes actuelles peuvent franchir avec la répétabilité qu'exige cette industrie. Pour ce cas d'usage, la robotique agentique offre quelque chose que les paris sur les humanoïdes à usage général ne proposent pas encore : une fiabilité vérifiable dans des conditions de précision extrême.
C'est là que Torsten Kroeger, directeur scientifique d'Intrinsic, la société de robotique d'Alphabet, pose le frein avec plus de rigueur technique. Son argument n'est pas que l'approche est erronée, mais que le problème du contact physique n'est résolu par aucun moteur physique existant. La simulation peut paraître identique à la réalité ; cela ne garantit pas que le comportement mécanique — la friction, la déformation, l'impact — soit modélisé avec la fidélité dont un robot a besoin pour manipuler des objets dans des conditions industrielles réelles. Ce fossé n'est pas comblé par l'agence des modèles, mais par la physique du simulateur. Et sur ce front, l'ensemble du domaine accuse toujours du retard.
Kroeger soulève également une question qui aura des conséquences réglementaires avant que le secteur ne l'ait résolue sur le plan conceptuel : si des agents génèrent et modifient de manière autonome du code pour des robots, comment établir que ce code est toujours sûr. L'argument n'est pas que les agents échouent, mais qu'à mesure que l'échelle des modifications autonomes croît, la révision humaine devient progressivement moins faisable. C'est le problème d'alignement transposé à la fabrication physique, avec des conséquences bien plus concrètes que dans le logiciel pur.
L'argument le plus intéressant n'est pas la performance : c'est l'architecture de la valeur
Les résultats de benchmark sont la partie la plus facile à communiquer et probablement la moins pertinente pour décider si cette direction a un avenir en production. Ce qui importe davantage, c'est une thèse que Huang a formulée vers la fin de sa présentation et qui mérite d'être examinée avec soin.
Son argument est que l'intelligence générale en robotique arrivera d'abord sous la forme d'un agent orchestrant des technologies conventionnelles et des politiques spécialisées, et non comme un modèle unique qui apprend tout depuis zéro. Pour l'observateur extérieur, le résultat ressemble à de l'intelligence générale parce que l'agent coordonne tout de manière cohérente. En dessous, des composants bien définis font ce qu'ils savent faire.
Cela a des implications sur la façon dont la valeur se distribue dans l'industrie. NVIDIA ne mise pas uniquement sur la vente de puissance de calcul pour entraîner des robots. Elle mise sur le fait que le processus de développement — simulation, génération de code, validation et reconfiguration des robots — passe par son infrastructure logicielle. Isaac Lab-Arena, le moteur physique Newton, les bibliothèques de robotique : si les agents qui génèrent du code pour des robots utilisent ces outils par défaut parce qu'ils sont disponibles et bien documentés, NVIDIA devient la couche de développement standard de l'industrie, et pas seulement un fournisseur de puces.
Il existe par ailleurs un argument de rétroaction que Huang a mentionné explicitement : le code généré par des agents pour des robots peut devenir des données d'entraînement pour les modèles suivants. Si cela se confirme, la robotique agentique ne résout pas seulement le problème de rareté des données d'aujourd'hui. Elle crée un mécanisme pour les générer à grande échelle, avec une haute qualité et une structure sémantique claire que les données de démonstration humaine ont rarement.
Le vrai risque n'est pas que l'approche ne fonctionne pas en simulation. Il y a déjà des preuves que ça fonctionne. Le risque est celui qui accompagne toujours les paris techniquement corrects mais prématurés dans leur transfert au monde physique : que la distance entre le laboratoire et la ligne de production consume la marge d'avantage avant que le marché puisse la valider. Les fabricants qui évaluent cela n'achètent pas un article de recherche affichant 99 % de taux de réussite en simulation. Ils achètent une fiabilité démontrée dans leur usine, avec leurs robots, leurs matériaux et leurs tolérances. Cette validation est encore en attente, et c'est elle qui déterminera si cette direction devient un standard ou une itération de plus sur le chemin vers quelque chose qui reste encore à définir.