KI im Feld hat kein Technologieproblem – sie hat ein Designproblem
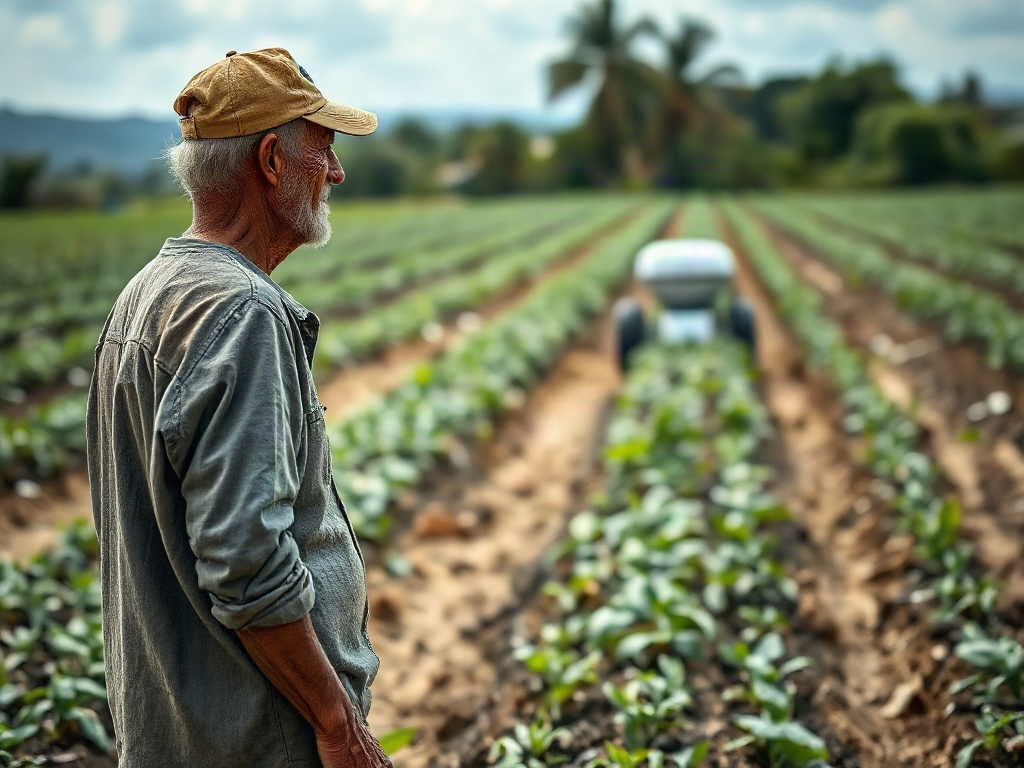
Es gibt ein Gespräch, das auf nahezu jedem Agroindustriekongress der Gegenwart stattfindet: das Versprechen autonomer Roboter, die ernten, sprühen, überwachen und transportieren, ohne dass ein einziger Mensch seinen Rücken unter der Sonne krümmen muss. Die Präsentationen sind makellos. Die Renderings beeindruckend. Und im Saal, nahe dem Ausgang, sitzen die Menschen, deren Arbeit gerade automatisiert wird – und die niemand eingeladen hat, irgendetwas mitzugestalten.
Das ist kein Detail. Es ist der strukturelle Riss, der die gesamte Debatte über Physische Künstliche Intelligenz in der Landwirtschaft durchzieht. Die Technologie existiert. Die konzeptuellen Rahmenbedingungen werden Monat für Monat ausgefeilter. Doch die Machtarchitektur, die darüber entscheidet, wer gestaltet, wer profitiert und wer die Kosten des Wandels trägt, bleibt unangetastet – und in vielen Fällen unsichtbar.
Das von der STATERA-Bibliothek veröffentlichte Kapitel über landwirtschaftliche Anwendungen Physischer KI beschreibt den Stand der Technik mit bemerkenswerter Präzision: mobile Roboter, die zwischen Furchen navigieren, Drohnen, die Wasserstress kartieren, Manipulatoren, die den Reifegrad einzelner Früchte erkennen, koordinierte Flotten, die Aufgaben nach Energieverfügbarkeit und Standort verteilen. Es ist eine ernsthafte technische Bestandsaufnahme. Aber wie jede Karte zeigt sie nur das Terrain, das ihre Autoren einzuschließen beschlossen haben.
Was auf dieser Karte nicht erscheint, sagt ebenfalls etwas aus.
Wenn der Algorithmus nur einen einzigen Standpunkt kennenlernt
Die technische Schicht des Problems ist paradoxerweise die am leichtesten zu benennen. Jedes System zur Computer Vision, das lernt, eine reife Frucht von einer unreifen oder ein Unkraut von einer Nutzpflanze zu unterscheiden, lernt anhand von Daten, die von jemandem etikettiert wurden. Diese Person hat ein Kriterium, eine Erfahrung, einen geografischen Kontext und eine spezifische Agrarkultur. Wenn die Trainingsdatensätze überwiegend von technisierten Betrieben des Globalen Nordens stammen, von Monokulturen mit RTK-GNSS-Infrastruktur, von Licht- und Reihenbedingungen, die in der kleinbäuerlichen Landwirtschaft Lateinamerikas oder Subsahara-Afrikas schlicht nicht existieren, dann versagt das System in diesen Regionen nicht wegen technischer Einschränkungen. Es versagt, weil es mit einem bestimmten Blickwinkel trainiert wurde – und dieser Blickwinkel diese Felder niemals einschloss.
Das STATERA-Kapitel weist selbst mit Bedacht darauf hin: „Modelle, die in begrenzten Umgebungen trainiert wurden, können bei der Bereitstellung unter unbekannten landwirtschaftlichen Bedingungen schlechte Leistungen erbringen." Die Aussage ist korrekt und zugleich unzureichend. Es handelt sich nicht nur um ein Problem der statistischen Generalisierung. Es ist ein Problem, wer im Raum war, als entschieden wurde, welche Daten zu erheben, welche Symptome als Krankheit zu etikettieren und welche Kulturpflanzensorte als Grundfall des Modells zu gelten hat.
Ungleichheit wird nicht im Moment des Einsatzes automatisiert. Sie wird im Moment des Designs automatisiert. Und das Design von KI-Systemen für die Landwirtschaft findet zum größten Teil in universitären Labors und Startups im Silicon Valley oder in Wageningen statt, mit Zugang zu Pilotbetrieben, die nach ihrer Infrastruktur ausgewählt wurden – nicht nach ihrer Repräsentativität für die reale globale Lebensmittelproduktion. Das Ergebnis ist eine Technologie, die die Produktivität dort steigert, wo bereits Produktivität vorhanden ist, und die dort zu spät, zu teuer oder schlicht irrelevant ankommt, wo sie am dringendsten gebraucht würde.
Das ist keine moralische Kritik an einzelnen Ingenieuren. Es ist eine strukturelle Beobachtung über die Anreize des Ökosystems, das die Forschung finanziert, die Anwendungsfälle auswählt und entscheidet, welches Problem groß genug ist, um eine Lösung zu verdienen.
Die Geometrie des Ausgeschlossenseins
Die Architektur des Sozialkapitals in der Wertschöpfungskette der landwirtschaftlichen KI folgt einem Muster, das es sichtbar zu machen lohnt. Im Mittelpunkt stehen die Technologieanbieter, Risikokapitalgeber, große Genossenschaften und Einzelhändler, die Rückverfolgbarkeit und Zertifizierung einfordern können. An der Peripherie befinden sich kleine und mittlere Unternehmen (KMU) in der Landwirtschaft, Saisonarbeiterinnen und Saisonarbeiter, indigene Gemeinschaften mit über Generationen angesammeltem Gebietswissen und Feldtechnikerinnen und Feldtechniker, die derzeit Symptome interpretieren, die kein Modell gelernt hat zu lesen.
Die dominierende Erzählung vom Arbeitskräftemangel – die das STATERA-Kapitel als einen der Treiber der Automatisierung präsentiert – verdient es, mit chirurgischer Genauigkeit gelesen zu werden. Mangel ist kein neutrales Phänomen. In vielen Regionen ist der Mangel an Landarbeiterinnen und Landarbeitern das Ergebnis jahrzehntelanger gedrückter Löhne, nicht nachhaltiger Arbeitsbedingungen und fehlender sozialer Absicherung. Diesen Mangel zu automatisieren, ohne seine Ursachen behoben zu haben, beseitigt nicht die systemische Vulnerabilität; sie verschiebt sie. Arbeiterinnen und Arbeiter, die ihr Saisoneinkommen in einem Kontext verlieren, in dem es kein Sicherheitsnetz gibt, verschwinden nicht aus dem Problem. Sie kehren in anderer Form zu ihm zurück – als Verbraucherinnen und Verbraucher mit geringerer Kaufkraft, als sich entleerende ländliche Gemeinden, als Migrationsdruck, den kein Aufsichtsrat eines Agroindustrieunternehmens als eigene externe Kosten anerkennen möchte.
Es gibt einen Grund, warum das technische Kapitel der Wirtschaftlichkeit von Landwirtschaftsrobotern ein eigenes Unterkapitel widmet und dennoch keinerlei Analyse der Verteilungswirkung dieser Wirtschaftlichkeit enthält. Das vorgestellte Modell der Kapitalrendite ist in sich korrekt: Es berechnet Produktivstunden, Kosten pro behandeltem Hektar, Einsparungen bei Betriebsmitteln. Was es nicht berechnet, sind die Kosten, die andere Akteure im System tragen, wenn diese Effizienz in einem Knoten gebündelt und nicht verteilt wird.
Die saisonale Auslastung ist die finanzielle Achillesferse des Modells. Ein Ernteroboter, der vier Wochen im Jahr läuft und den Rest der Zeit stillsteht, braucht Modelle wie Robotics-as-a-Service, gemeinschaftliches Eigentum oder den Einsatz über mehrere Kulturen, um wirtschaftlich Sinn zu ergeben. Diese Modelle existieren auf dem Papier. Doch ihre reale Skalierung hängt von Logistikinfrastruktur, Konnektivität, lokaler technischer Kapazität und institutionellem Vertrauen ab – Variablen, die genau dort im Überfluss vorhanden sind, wo die Technologie bereits gut funktioniert, und genau dort knapp sind, wo sie am meisten verändern könnte.
Das periphere Wissen, das das Modell nicht erfasst
Es gibt eine Art von Wissen, die aktuelle landwirtschaftliche KI-Systeme nicht verarbeiten können, weil es weder digitalisiert noch etikettiert noch in irgendeinen Trainingsdatensatz aufgenommen wurde. Es ist das Wissen, das an der Peripherie des Systems lebt: beim Tagelöhner, der am Geruch des Bodens erkennt, ob es regnen wird; bei der Bäuerin, die den Reifegrad einer lokalen Sorte unterscheidet, die in keinem kommerziellen Katalog existiert; beim landwirtschaftlichen Berater, der seit fünfzehn Jahren mental die Schädlingsbefallsmuster in einem bestimmten Einzugsgebiet kartiert.
Dieses Wissen ist kein Folklore. Es ist operatives, unter realer Unsicherheit angesammeltes Erfahrungswissen, erarbeitet mit begrenzten Ressourcen und mit direkten Konsequenzen für die Existenzsicherung. Es ist genau die Art von Intelligenz, die physische KI-Systeme brauchen, um in unstrukturierten Umgebungen zu funktionieren – und genau das ist die Landwirtschaft der realen Welt.
Das Problem besteht nicht darin, dass Ingenieurinnen und Ingenieure dieses Wissen ignorieren, weil sie es für minderwertig halten. Das Problem ist, dass die Architektur des technologischen Entwicklungssystems keine Mechanismen hat, um es einzubinden. Es gibt kein standardisiertes Verfahren, mit dem eine Feldtechnikerin in Oaxaca oder im Senegal Trainingsdaten mit ihrem lokalen agronomischen Urteil etikettieren könnte. Es gibt keine Rückmeldungsschnittstelle, die es einem Landwirt erlaubt, die Diagnose eines Modells zu korrigieren, wenn das Modell sich irrt. Es gibt kein Geschäftsmodell, das dieses Wissen in der gleichen Weise vergütet wie Hardware oder Computer-Vision-Software.
Das STATERA-Kapitel erkennt an, dass „datenbasiertes Lernen die Leistung von Landwirtschaftsrobotern durch akkumulierte Beobachtungen und Ausführungsergebnisse verbessern kann." Das stimmt. Aber die akkumulierten Daten erfassen nur das, was das System von Beginn an zu beobachten ausgelegt wurde. Die Intelligenz, die außerhalb dieses Sichtfelds liegt, verbessert das Modell nicht. Für das Modell existiert sie schlicht nicht.
Was die Systemarchitektur offenbart – nicht die Technologie
Physische KI in der Landwirtschaft ist keine gescheiterte Technologie. Es ist eine Technologie, die innerhalb der Grenzen ihres eigenen Designs gut funktioniert und das Potenzial hat, transformativ zu sein, wenn sich verändert, wer an diesem Design mitwirkt. Der Unterschied zwischen diesen beiden Versionen ist nicht technischer Natur. Er ist struktureller Natur.
Digitale Zwillinge von Betrieben, koordinierte Roboterflotten, Präzisionssprühsysteme, die einzelne Düsen im Millimeterbereich synchronisiert aktivieren – all das stellt eine echte Fähigkeit dar, die operative Intelligenz in der Lebensmittelproduktion zu steigern. Doch diese Fähigkeit fließt dorthin, wo bereits Kapital für ihre Einführung vorhanden ist, Infrastruktur zu ihrem Erhalt und Verhandlungsmacht, um ihre Funktion einzufordern.
Die Homogenität der Designteams ist kein Problem symbolischer Repräsentation. Es ist ein Problem operativer blinder Flecken, die in die Modelle eincodiert werden, bevor sie irgendjemand zu Gesicht bekommt. Ein Team, das gleichartig denkt, teilt dieselben Annahmen darüber, welches Feld der Grundfall ist, welche Sorte der Standard, welche Lichtverhältnisse die Norm und welche Landwirtin oder welcher Landwirt die Musternutzerin oder der Musternutzer ist. Diese Annahmen werden in keinem Anforderungsdokument deklariert. Sie fließen still und leise in jede Designentscheidung ein.
Die Fragilität eines landwirtschaftlichen KI-Systems, das aus einem einzigen Blickwinkel heraus entworfen wurde, zeigt sich nicht im Labor. Sie zeigt sich im dritten Monat des Einsatzes, wenn das Modell auf eine lokale Sorte trifft, die es nie gesehen hat, oder wenn der Boden eine Zusammensetzung aufweist, die kein Sensor im Trainingsdatensatz je gemessen hat, oder wenn die Reihengeometrie mit keiner der Geometrien übereinstimmt, die das System interpretieren gelernt hat. In diesem Moment hält der Roboter an, trifft die falsche Entscheidung oder erfordert menschlichen Eingriff. Und der menschliche Eingriff, der auf diesem Feld zur Verfügung steht, hat nicht die Ausbildung, um zu verstehen, warum das System versagt hat.
Peripheres Wissen ist keine freundliche Ergänzung zur landwirtschaftlichen KI. Es ist die Bedingung ihrer Zuverlässigkeit in der realen Welt. Systeme, die ohne die Einbeziehung dieses Wissens von Beginn an entworfen werden, werden nicht durch bessere Versionen ersetzt. Sie werden von den Nutzerinnen und Nutzern aufgegeben, die am meisten von ihnen profitieren könnten, und ausschließlich von jenen übernommen, die bereits über genug Kapital verfügten, um ihre Einschränkungen auszugleichen.
Das löst weder das Problem des Arbeitskräftemangels noch das der globalen Ernährungssicherheit. Es konzentriert lediglich die Vorteile der Automatisierung dort, wo sich bereits zuvor alle anderen Vorteile konzentrierten. Die Machtarchitektur hat sich nicht verändert. Sie ist nur innerhalb ihrer eigenen Grenzen effizienter geworden.