Wenn das Programmieren von Robotern aufhört, ein Datenproblem zu sein
Dem Großteil des Kapitals, das in den vergangenen drei Jahren in die Robotik geflossen ist, liegt eine implizite Wette zugrunde: dass Roboter lernen werden, das zu tun, was Menschen tun, wenn ihnen nur genügend menschliche Demonstrationen zur Verfügung gestellt werden. Die Logik ist verführerisch, weil sie einmal funktioniert hat – bei Sprachmodellen. Doch Robotik ist kein Text, und dieser Unterschied beginnt denjenigen teuer zu werden, die annahmen, dasselbe Rezept würde dasselbe Ergebnis liefern.
Was UC Berkeley und NVIDIA auf der Conference on Robot Learning 2026 vorgestellt haben, ist keine schrittweise Verbesserung dieses Paradigmas. Es ist ein Bruch mit ihm. Der Ansatz, den sie agentische Robotik nennen, geht davon aus, dass das Problem nicht ein Mangel an Daten war, sondern dass man den falschen Engpass anging.
Das Plateau, das niemand verkünden wollte
Ken Goldberg, Robotikprofessor an der UC Berkeley und Mitgründer von Ambi Robotics, arbeitet seit Jahren mit Industrieherstellern zusammen, darunter Siemens und Bosch. Seine Diagnose ist direkt: Imitationslernen funktioniert bis zu einem gewissen Punkt – und dieser Punkt wird schneller erreicht, als Investoren erwartet hatten. „Man erzielt anfangs mit Daten gute Leistung, aber dann läuft etwas schief. Man fügt mehr Daten hinzu. Doch dann laufen andere Dinge schief", beschrieb er. Es gibt kein klares Anzeichen dafür, dass das System konvergiert.
Das grundlegende Problem ist struktureller Natur. Sprachmodelle wurden mit einem erheblichen Bruchteil aller Texte trainiert, die die Menschheit je produziert hat. Es gibt keinen Robotik-Datensatz, der auch nur annähernd diese Größenordnung erreicht, und ihn physisch aufzubauen – durch aufgezeichnete menschliche Demonstrationen in realen Umgebungen – ist ein langsamer und kostspieliger Prozess. Unternehmen, die Kapital unter der Prämisse aufgenommen haben, dass Daten alles lösen würden, stehen heute vor einer unbequemen Frage: Wie viel fehlt noch, und wird dieses „genug" jemals erreicht sein, bevor die Geduld des Marktes erschöpft ist?
Was die Diagnose noch komplizierter macht, ist, dass Imitationslernen Systeme erzeugt, die niemand leicht auditieren kann. Es sind Blackboxen mit hoher durchschnittlicher Leistung, die zum ungünstigsten Moment auf unvorhersehbare Weise versagen können. Für industrielle Anwendungen, wo „Versagen" eine stillstehende Produktionslinie oder eine Verletzung bedeuten kann, ist dieses Risikoprofil schwer vor einem Betriebsausschuss zu rechtfertigen.
Code statt Daten: die Wende, die Berkeley und NVIDIA vorschlagen
Die agentische Robotik verwandelt das Problem der Datenknappheit in ein Problem der Codegenerierung. Und dafür haben Sprachmodelle tatsächlich ausreichend Skalierung.
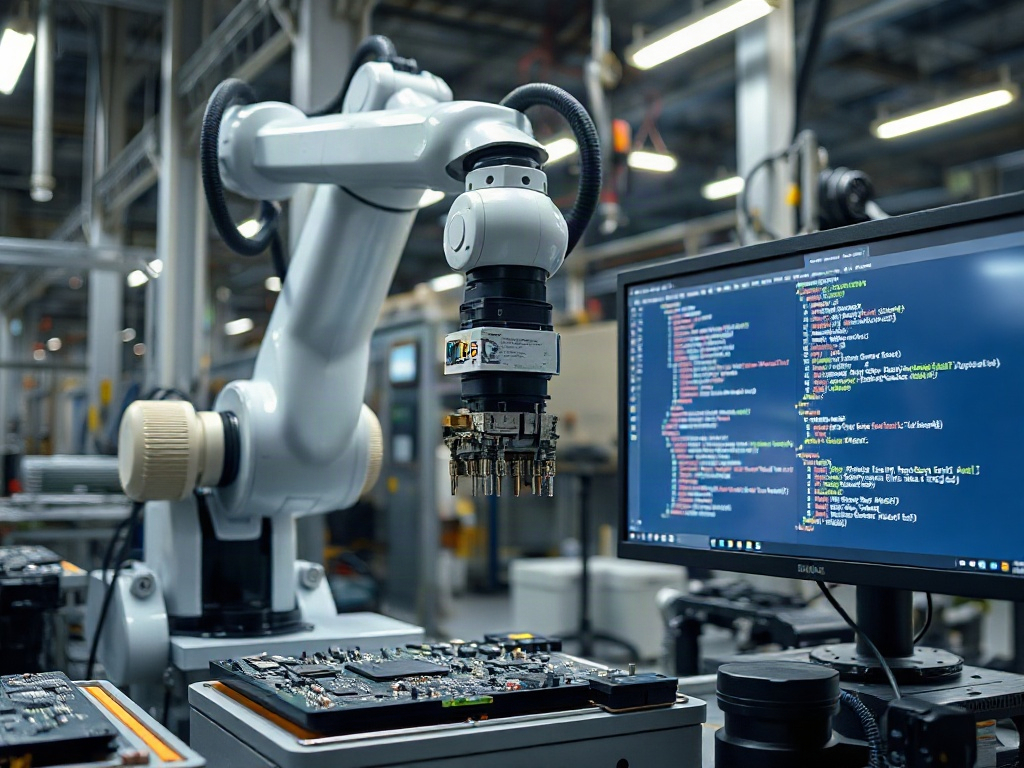
Der Ablauf funktioniert so: Ein Ziel in natürlicher Sprache – beispielsweise Produkte in eine Tüte verpacken oder Spritzen in einem Abfallbehälter ablegen – wird in Teilaufgaben zerlegt. Spezialisierte Code-Agenten, also autonome KI-Systeme, die in der Lage sind, Software zu schreiben, zu testen und zu modifizieren, übernehmen spezifische Funktionen: visuelle Wahrnehmung, Posenschätzung, Bewegungsplanung, Greifer-Steuerung. Jeder Agent nutzt bereits vorhandene Robotik-Bibliotheken, die Jahrzehnte an Entwicklung in Objektklassifizierung, Trajektorienplanung und Bewegungssteuerung repräsentieren. Der resultierende Code wird in der Simulation ausgeführt, die Agenten identifizieren Fehler, passen Parameter an und iterieren erneut.
Das in den Berkeley-Tests dokumentierte Ergebnis erreichte Erfolgsquoten von bis zu 99 % bei den evaluierten Aufgaben, verglichen mit etwa 20 % bei Imitationslernmethoden für dieselben Aufgaben. Die Lücke ist nicht marginal.
Eine Dimension, die Aufmerksamkeit verdient, ist die Simulation selbst. Eine simulierte Umgebung mit ausreichender Präzision zu konfigurieren, damit der generierte Code in der physischen Welt nützlich ist, war bislang eine arbeitsintensive manuelle Aufgabe. Was Goldberg und sein Team zeigten, ist, dass ein Agent die Parameter des Simulators – Beleuchtung, Geometrie, Hintergrund – so anpassen kann, dass sie mit einem Video der realen Umgebung übereinstimmen. Goldbergs Beschreibung war eindringlich: „Es lief uns kalt den Rücken herunter. Im direkten Vergleich nebeneinander war es sehr schwer, die Simulation vom Video zu unterscheiden." Das löst zwar nicht das Problem des physischen Transfers, beseitigt aber eine Schicht an Ingenieurarbeit, die zuvor Spezialisten erforderte.
Die Architektur umfasst außerdem eine Qualitätssicherungsebene: einen adversarialen Agenten, der darauf ausgelegt ist, Fehler in dem zu finden, was ein anderer Agent produziert. Spencer Huang, Director of Engineering für Robotik bei NVIDIA, beschrieb das nüchtern: „Wir alle wissen, dass KI-Agenten Unsinn produzieren können. Um dem entgegenzuwirken, verwenden wir adversariale Setups." Das ist eine Möglichkeit, Skepsis in den Prozess einzubetten – nicht als externe Korrektur, sondern als Teil des Entwicklungszyklus.
Was in der Fertigung funktioniert und was draußen noch nicht klappt
Der konkreteste Fall, der aus der Forschung hervorgeht, betrifft Wistron, den taiwanischen Hersteller von Hauptplatinen für NVIDIA-GPUs. Wenn dieses Unternehmen ein neues Produkt in seine Linie aufnimmt, dauert die Neukonfiguration eines einzelnen Roboters mindestens acht Stunden. Mit agentischer Robotik, so Huang, sinkt diese Zeit auf ein bis zwei Minuten. Wenn diese Zahl in der echten Produktion standhält, ist der Einfluss nicht nur operativ, sondern finanzieller Natur: kürzere Produktionsläufe, höhere Geräteauslastung, Reaktionsfähigkeit auf Produktänderungen, die heute Wochen vorauszuplanen sind.
Ein weiteres Beispiel, das Huang anführt, ist die Halbleiterindustrie, wo einige Montageprozesse das Platzieren von Bauteilen mit einer Präzision von 0,3 Millimetern erfordern. Das ist ein Schwellenwert, den gut programmierte konventionelle Industrieroboter erfüllen können. Es ist kein Schwellenwert, den aktuelle humanoide Roboterplattformen mit der Wiederholgenauigkeit erreichen können, die diese Industrie verlangt. Für diesen Anwendungsfall bietet die agentische Robotik etwas, das die Wetten auf universell einsetzbare humanoide Roboter noch nicht bieten: nachweisliche Zuverlässigkeit unter extremen Präzisionsbedingungen.
Genau hier legt Torsten Kroeger, wissenschaftlicher Direktor von Intrinsic, dem Robotik-Unternehmen von Alphabet, mit größerer technischer Strenge den Finger in die Wunde. Sein Argument ist nicht, dass der Ansatz falsch sei, sondern dass das Problem des physischen Kontakts durch keine bestehende Physik-Engine gelöst wird. Die Simulation kann der Realität identisch erscheinen; das garantiert nicht, dass das mechanische Verhalten – Reibung, Verformung, Aufprall – mit der Genauigkeit modelliert wird, die ein Roboter benötigt, um Objekte unter realen Industriebedingungen zu handhaben. Diese Lücke schließt nicht die Handlungsfähigkeit der Modelle, sondern die Physik des Simulators. Und auf dieser Front hinkt das gesamte Feld noch hinterher.
Kroeger stellt zudem etwas in den Raum, das regulatorische Konsequenzen haben wird, bevor der Sektor es konzeptuell gelöst hat: Wenn Agenten Code für Roboter autonom generieren und modifizieren, wie lässt sich feststellen, dass dieser Code jederzeit sicher ist. Das Argument ist nicht, dass Agenten versagen, sondern dass mit wachsendem Umfang autonomer Modifikationen die menschliche Überprüfung zunehmend weniger praktikabel wird. Das ist das Ausrichtungsproblem, übertragen auf physische Fertigung, und es hat weitaus konkretere Konsequenzen als in reiner Software.
Das interessanteste Argument ist nicht die Leistung: es ist die Wertarchitektur
Die Benchmark-Ergebnisse sind der am leichtesten zu kommunizierende Teil und wahrscheinlich der am wenigsten relevante, um zu entscheiden, ob diese Richtung in der Produktion Zukunft hat. Was mehr zählt, ist eine These, die Huang gegen Ende seiner Präsentation formulierte und die es verdient, sorgfältig geprüft zu werden.
Sein Argument lautet, dass die allgemeine Intelligenz in der Robotik zuerst in Form eines Agenten kommen wird, der konventionelle Technologien und spezialisierte Politiken orchestriert – nicht als ein einziges Modell, das alles von Grund auf neu erlernt. Für den externen Beobachter sieht das Ergebnis nach allgemeiner Intelligenz aus, weil der Agent alles kohärent koordiniert. Darunter befinden sich klar definierte Komponenten, die das tun, was sie können.
Das hat Implikationen dafür, wie der Wert in der Branche verteilt wird. NVIDIA wettet nicht nur darauf, Rechenleistung für das Training von Robotern zu verkaufen. Es wettet darauf, dass der Entwicklungsprozess – Simulation, Codegenerierung, Validierung und Retasking von Robotern – über seine Software-Infrastruktur läuft. Isaac Lab-Arena, die Physik-Engine Newton, die Robotik-Bibliotheken: Wenn die Agenten, die Code für Roboter generieren, diese Werkzeuge standardmäßig verwenden, weil sie verfügbar und gut dokumentiert sind, wird NVIDIA zur Standard-Entwicklungsschicht der Industrie – nicht nur zum Chip-Lieferanten.
Es gibt zudem ein Rückkopplungsargument, das Huang explizit erwähnte: Der von Agenten für Roboter generierte Code kann zu Trainingsdaten für nachfolgende Modelle werden. Wenn das zutrifft, löst agentische Robotik nicht nur das heutige Datenknappheitsproblem. Sie schafft einen Mechanismus, um Daten in großem Maßstab zu erzeugen – mit hoher Qualität und klarer semantischer Struktur, die Demonstrationsdaten von Menschen selten aufweisen.
Das eigentliche Risiko besteht nicht darin, dass der Ansatz in der Simulation nicht funktioniert. Es gibt bereits Belege dafür, dass er funktioniert. Das Risiko ist dasjenige, das stets technisch korrekte, aber bei der Übertragung in die physische Welt verfrühte Wetten begleitet: dass die Distanz zwischen dem Labor und der Produktionslinie den Vorteil aufzehrt, bevor der Markt ihn validieren kann. Die Hersteller, die das gerade evaluieren, kaufen keinen Fachartikel mit 99 % Erfolgsquote in der Simulation. Sie kaufen nachgewiesene Zuverlässigkeit in ihrer eigenen Anlage, mit ihren eigenen Robotern, Materialien und Toleranzen. Diese Validierung steht noch aus – und sie wird entscheiden, ob diese Richtung zum Standard wird oder eine weitere Iteration auf dem Weg zu etwas bleibt, das noch zu definieren ist.